SEDD:通过学习概率比构建离散扩散模型
论文:Discrete Diffusion Modeling by Estimating the Ratios of the Data Distribution
作者:Aaron Lou、Chenlin Meng、Stefano Ermon(Stanford University;Chenlin Meng 同时隶属 Pika Labs)
版本:arXiv:2310.16834v3,2024-06-06 修订,ICML 2024
研读与获取日期:2026-10-14
原文:arXiv v3 · 本地 PDF
配套汇报:英文幻灯片 PDF · 可编辑 TeX
论文总览
连续扩散模型通过学习 $\nabla_x\log p_t(x)$ 来逆转加噪过程,但 token 没有自然的连续空间梯度。SEDD(Score Entropy Discrete Diffusion)的出发点是:离散连续时间马尔可夫链的逆转移率,只需要知道状态之间的概率比 $p_t(y)/p_t(x)$。 因此,可以直接学习这些比值,而不先恢复整个归一化分布。
论文真正推进的是“怎样把概率比学好”。作者提出 score entropy,将正值比率的误差写成 $s-r+r\log(r/s)$;再用去噪恒等式,把不可计算的边缘分布比率换成已知加噪核的条件比率。选取与前向转移率相同的权重后,这个目标还给出负对数似然上界。训练目标、反向过程和概率评估由此连在一起。(Sec. 2–3,PDF pp. 2–4,Eqs. (3)、(5)、(7)、(9)–(10))
在实验中,吸收态版本 SEDD Absorb 最强。专门在 1BW 上训练时,困惑度上界为 32.79,接近自回归 Transformer 的 31.98;OpenWebText 训练后的零样本评估中,在 small、medium 两种规模下,SEDD Absorb 均有 3/5 个数据集的报告值优于 GPT-2。生成方面,模型允许在采样步数与质量之间取舍,并支持固定任意位置的文本来填空。这里的生成质量主要由 GPT-2 large 给样本打分,不能与模型在真实文本上的困惑度混为一谈。(Tables 1–3,PDF p. 6;Fig. 1,PDF p. 7;Table 5,PDF p. 8)
结构地图
以下均使用从 1 开始的 PDF 页码,与本版本印刷页码一致。
| 原文章节 | 论证作用 | 定位 |
|---|---|---|
| 1 Introduction | 为什么需要自回归之外的文本生成方式 | pp. 1–2 |
| 2 Preliminaries | 连续时间离散扩散、逆过程和既有训练方法 | p. 2,Eqs. (1)–(4) |
| 3 Score Entropy Discrete Diffusion Models | 损失、去噪等价式、似然界与高维实现 | pp. 2–4,Eqs. (5)–(16) |
| 4 Simulating Reverse Diffusion with Concrete Scores | Euler / Tweedie 采样和任意位置条件生成 | pp. 4–5,Eqs. (17)–(22) |
| 5 Experiments | 似然评估、无条件生成、条件生成 | pp. 5–8,Tables 1–5、Fig. 1 |
| 6 Related Work | 与既有扩散目标的关系,以及 KV cache 下的速度取舍 | pp. 8–9 |
| 7 Conclusion | 贡献归纳 | p. 9 |
| A Proof of Main Results | 一致性、去噪等价、路径 KL 和采样命题的证明 | pp. 12–14 |
| B Algorithms for Training and Inference | 训练与两类生成算法 | pp. 14–15,Algorithms 1–3 |
| C Additional Experimental Details | 噪声、模型、训练与评估协议 | pp. 15–16 |
| D Additional Experimental Results | 损失消融、Uniform 采样曲线与生成样例 | pp. 17–30,Figs. 2–14 |
一:动机——离散扩散缺少合适的 score 学习目标
1.1 文本为什么难以直接照搬连续扩散
自回归建模用链式法则分解序列概率,生成时逐 token 采样,天然适合从左到右续写。扩散则希望从整段噪声逐步恢复整段文本,使不同位置能够共同更新,也方便利用前缀、后缀或分散的提示。
把 token 嵌入连续空间、加高斯噪声,再映射回词表,是已有路线之一;另一条路线直接在离散 token 间跳转。SEDD 采用后一种。它面临的关键问题不是是否存在反向马尔可夫链,而是如何用一次常规 Transformer 前向计算,稳定估计逆过程所需的比率。
1.2 本文相对已有方法改变了什么
| 方法 | 学习对象或目标 | 本文关注的不足 |
|---|---|---|
| Mean prediction / D3PM 路线 | 预测干净数据后验 $p_{0\mid t}$,再构造逆过程 | 概率单纯形参数化与连续时间目标处理较间接 |
| Ratio matching | 通过逐位置条件概率获得比率 | 某些实现需要专用架构,计算昂贵 |
| Concrete score matching(CSM) | 对比率使用平方误差 | 目标对接近零的正值预测惩罚不合适,实测优化困难 |
| SEDD | 直接输出正值比率,以去噪 score entropy 训练 | 使目标与逆转移率、似然界及标准序列网络相容 |
概率比作为离散 score 并非本文首次提出;本文的主要增量是 score entropy 及其可扩展的去噪形式,加上语言建模验证。作者也明确说明,扩散加权目标与此前连续时间离散扩散的似然目标存在等价关系。(Sec. 2.2,PDF p. 2;Sec. 3.2,PDF p. 4;Sec. 6,PDF pp. 8–9)
二:方法——从概率比到训练、采样和填空
2.1 先固定符号和转移矩阵方向
| 符号 | 含义 |
|---|---|
| $\mathcal X$ | 有限状态空间;对文本为整段序列的集合 |
| $p_t(x)$ | 加噪至时刻 $t$ 后,状态 $x$ 的概率质量 |
| $Q_t(y,x)$ | 前向过程从 $x$ 跳到 $y$ 的瞬时率,$x\ne y$ |
| $\bar Q_t(y,x)$ | 反向过程中从当前 $x$ 跳到 $y$ 的瞬时率 |
| $s_\theta(x,t)_y$ | 网络估计的 $p_t(y)/p_t(x)$,无量纲、非归一化 |
| $d,n$ | 序列长度、词表大小;吸收态模型另含 MASK |
| $\sigma(t),\bar\sigma(t)$ | 噪声速率及其积分 $\int_0^t\sigma(u)\,du$ |
| $p_{\rm base}$ | 高噪声端用于启动反向生成的简单分布 |
论文采用列概率向量:
于是短时转移满足
反向非对角率为
注意右侧是 $Q_t(x,y)$:它对应前向的 $y\to x$。一个直接的理解是小时间内的概率流匹配:
网络因此只需估计比率。替换成 $s_\theta$ 后,另设对角元为各个离开率之和的负值,就得到合法的反向生成器。连续 score 的离散类比可由有限差分理解:$(p(y)-p(x))/p(x)=p(y)/p(x)-1$。(Sec. 2.1,PDF p. 2,Eqs. (1)–(3))
2.2 Score entropy 为什么适合正值比率
令真实比率 $r=p(y)/p(x)$、预测为 $s>0$。单对状态的损失可整理为
完整目标是
$w_{xy}\ge0$ 控制哪些比率需要学习。$K(r)=r(\log r-1)$ 与模型参数无关,使目标的最小值为零。固定 $r>0$ 时,
唯一最优解是 $s=r$。在分布有完整支持、所有所需权重为正、容量和样本数足够的条件下,便得到 Proposition 3.2 的一致性。凸性是对单个输出 $s$ 而言,不意味着神经网络参数优化是凸的。(Sec. 3.1,PDF p. 3;Appendix A,PDF p. 12)
与 $\ell_{\rm CSM}=\frac12(s-r)^2$ 相比,
当真实目标大于零但预测趋近零时,score entropy 会产生强烈惩罚。实践中作者将网络输出指数化来保证正值。教学推导:若 $s=e^z$,则
假设 $r=0.2$、$s=0.001$,两者对 $z$ 的梯度分别是 $-0.199$ 与 $-0.000199$。后者在预测很小时多乘了一个很小的 $s$,更难纠正低估。这解释了为什么仅保证输出为正,还不足以消除平方误差目标的优化问题。
公式解释上的更正:原文 p. 3 的 Remark 将 score entropy 描述为 symmetric,但式 (5) 的单项一般不对称。例如 $\ell(2;1)=1-\log2$,而 $\ell(1;2)=-1+2\log2$。按通常的 Bregman 定义,它可写为 $D_F(r,s)$,其中 $F(u)=u\log u-u$;也等于两个泊松分布之间的 KL。这里使用其非负性和对预测值的凸性,不使用“对称性”。当 $r=0$ 时按连续延拓取 $K(0)=0$,单项退化为 $s$。
2.3 不知道真实分布,怎样得到训练信号
直接目标包含 $p(y)/p(x)$,而我们只有数据样本。论文给出两种等价形式。
隐式 score entropy 利用换指标恒等式
得到
它不需要已知 $p$,但出现了以许多不同 $y$ 为输入的网络调用;再采样 $y$ 会引入方差。因此它不是本文大规模语言实验采用的训练方案。(Eq. (6),PDF p. 3)
去噪 score entropy 则使用已知加噪核。先采样干净序列 $x_0\sim p_0$,再采样 $x_t\sim p_{t\mid0}(\cdot\mid x_0)$。在适用的支持条件下,
这是条件比率在后验下的平均恒等式,并非单个加噪样本的目标就等于真实边缘比率。代入损失中线性出现的 $r\log s$ 项,得到与 $\mathcal L_{\rm SE}$ 相差参数无关常数的目标:
每次只在当前噪声序列 $x_t$ 上运行一次网络,就能得到需要的预测。这是去噪形式相对隐式形式的主要计算优势。(Theorem 3.4、Eq. (7),PDF p. 3;证明 PDF p. 12)
2.4 扩散权重如何把训练目标连接到似然
定义已知的条件目标
令 $w_{x_ty}=Q_t(x_t,y)$,并在时间上积分:
Theorem 3.6 给出
其证明的主线是:把“真实加噪路径的逆过程”与“模型生成路径”作 KL 比较;丢弃中间路径、只保留最终状态后,KL 不增。路径 KL 中,跳转率的失配恰好产生 $s-r+r\log(r/s)$;终点分布不匹配则贡献先验 KL。(Eqs. (9)–(10),PDF pp. 3–4;Appendix A,PDF pp. 12–13)
训练时可丢弃与 $\theta$ 无关的 $K(r)$;用于报告似然上界时,则必须使用相应的完整界及端点处理。因此表格中的 $\le32.79$ 表示困惑度的上界估计,不是直接算出的精确模型困惑度。论文用 1000 个随机时间点做 Monte Carlo 估计,实际报告值也有估计误差。(Appendix C.6,PDF p. 16)
吸收态过程还有一个端点细节:有限噪声时仍有少量非 MASK 概率,若先验严格只支持全 MASK,先验 KL 会无穷大。作者在评估先验中给非 MASK 状态极小的概率质量;实际生成则仍从 MASK 开始。(Appendix C.1,PDF p. 15)
2.5 序列空间指数大,为什么网络只需输出 $d\times n$
长度 $d$、词表 $n$ 的整段状态空间有 $n^d$ 个状态。论文让前向噪声逐位置独立作用,于是生成器只连接汉明距离为 1 的序列:
对当前位置 $i$、替换 token $a$,网络预测
只需要这些局部比率,是因为其他边的权重 $Q_t(\boldsymbol x,\boldsymbol y)$ 为零。网络输出规模降到 $d\times n$,可由带时间条件的双向 Transformer 实现。独立的是前向加噪核;数据分布和网络预测仍可以包含任意跨 token 依赖。
前向核可以分解:
当 $Q_t^{\rm tok}=\sigma(t)Q^{\rm tok}$ 时,
比较只差一个位置的序列时,条件比率中的其他因子全部约掉。大词表下也不必存储一般的 $n\times n$ 稠密矩阵:作者选用具有闭式核的 Uniform 和 Absorb。(Sec. 3.3,PDF p. 4,Eqs. (11)–(16))
2.6 Uniform 与 Absorb 的具体前向过程
令 $\alpha(t)=e^{-\bar\sigma(t)}$,干净 token 为 $a$。
| 版本 | 前向行为 | 单 token 转移核 | 高噪声端 |
|---|---|---|---|
| Uniform | 与均匀随机 token 混合 | $\alpha\delta_a+(1-\alpha)\mathbf1/n$ | 独立均匀 token |
| Absorb | 以一定概率替换成 MASK | $\alpha\delta_a+(1-\alpha)\delta_{\rm MASK}$ | 全 MASK |
Uniform 这一写法采用附录中实际使用的 $Q^{\rm uniform}/n$ 归一化;如果直接使用正文 Eq. (15) 未缩放的矩阵,指数衰减因子会是 $e^{-n\bar\sigma(t)}$。Absorb 的非 MASK token 只流向 MASK,MASK 不再离开。
几何噪声日程在总噪声 $10^{-5}$ 到 $20$ 之间插值。作者还试验了让扰动比例近似随 $t$ 线性变化的 log-linear 日程,对 Absorb 的困惑度更有利。(Sec. 5.1,PDF p. 5;Appendix C.1,PDF p. 15)
日程公式的读法:附录把 log-linear 写成 $\bar\sigma(t)=-\log(1-(1-\epsilon t))$,按字面等于 $-\log(\epsilon t)$,与随时间加噪、$t\to1$ 时稳定化的文字不一致。根据正文的扰动比例描述,可推得相容的形式为 $-\log(1-(1-\epsilon)t)$,此时 $1-e^{-\bar\sigma(t)}=(1-\epsilon)t$。后式是依据文字作出的数学解释,不把它冒充原文排印公式。
2.7 一次训练和一次生成分别做什么
一次训练的输入是干净文本和随机时间;输出是梯度更新。
- 采样 $\boldsymbol x_0$ 与 $t\sim{\rm Uniform}[0,T]$。
- 逐位置从已知核加噪,得到 $\boldsymbol x_t$。
- 双向 Transformer 读入整段 $\boldsymbol x_t$ 和总噪声 $\bar\sigma(t)$,输出正值 score。
- 计算局部条件比率,按 $Q_t$ 加权并求和,反向传播。
为明确权重而展开的教学写法如下,省去参数无关项:
$T$ 来自均匀时间采样;当 $T=1$ 时省略。Absorb 中只有当前为 MASK 的位置具有非零的相关反向边权重,不能对所有 token 替换无差别套用同一个损失。该表达式以正文 Eq. (10) 的完整权重为准。(Algorithm 1,PDF p. 14)
生成时不需要干净文本:从 $\boldsymbol x_T\sim p_{\rm base}$ 开始,在一串递减时间点预测 score、构造各位置的转移概率并同时采样,直到低噪声端。生成的迭代次数是采样超参数,可随计算预算改变。
2.8 并行更新:Euler 与 Tweedie $\tau$-leaping
若直接在整段序列的生成器上作一个 Euler 步,其非对角边只允许改变一个 token。$\tau$-leaping 改为在一次网络调用后,对各位置独立、同时采样,允许一步更新多个位置。
Euler 版本对 $a\ne x_t^i$ 使用
留在当前位置的概率为 $1$ 减去所有离开概率之和。较大步长或预测误差可能破坏非负性,论文算法会在需要时截断到非负并重新归一化。(Eq. (17),PDF p. 4;Algorithm 2,PDF p. 15)
Tweedie 版本利用概率比的额外结构。对于固定生成器 $Q$,完整 score 向量给出精确去噪公式:
这是 $p_0=e^{-tQ}p_t$ 与贝叶斯公式的组合。高维实现只沿一个 token 维度应用相同操作。设 $\Delta\bar\sigma=\bar\sigma(t)-\bar\sigma(t-\Delta t)$,得到
此处需把当前 token 对应的 score 补为自比率 1。各个位置再独立采样。已知结构的 $Q$ 使矩阵作用可闭式计算,不是在词表上做一般稠密矩阵指数。(Theorems 4.1–4.2、Eqs. (18)–(20),PDF p. 5)
“最优”有清晰的范围:当 score 完美时,这个更新给出各个旧时刻 token 在当前整段序列条件下的正确边缘分布,其乘积在所有独立位置更新中最小化
最优乘积分布仍会丢掉同一采样步内部的联合相关性。增大步数能够减小这一近似的影响;完美 score 的结论不自动消除训练误差。
2.9 任意位置提示:条件分布的归一化常数抵消
沿正文记号,$\Omega$ 为待生成位置、$\bar\Omega$ 为固定位置。固定文本为 $\boldsymbol y$,则
两者都除以的 $p_t(\boldsymbol y)$ 消掉了。因此同一 score 网络可以在包含提示的整段序列上运行,只更新 $\Omega$,固定位置保持原样。提示不必是前缀,也可以是后缀、中间片段或多个位置。(Sec. 4.2,PDF p. 5,Eqs. (21)–(22);Algorithm 3,PDF p. 15)
条件含义的补充分析:上式首先是同一时刻 $t$ 的条件概率恒等式。本文条件生成主实验使用 Absorb;在该过程里,非 MASK token 只可能来自原来同一个 token,且是否存活独立于其取值,因此保持提示为未遮盖 token 与对干净提示条件化相容。对 Uniform,观察到噪声时刻的某个 token 不意味着干净 token 相同,不能仅凭上式就断言任意冻结策略都精确采样干净条件分布。
2.10 教学补充:Absorb 为什么与掩码语言建模有关
对当前被遮盖的位置 $i$,记未遮盖上下文为 $c$。独立吸收噪声意味着
所以正确 score 的总和应为 $\alpha/(1-\alpha)$,归一化后则是对被遮盖 token 的条件预测。对一个训练样本,去掉常数后的相关损失是
如果另加参数化约束 $s_{\theta,i,a}=\frac{\alpha}{1-\alpha}\pi_{\theta,i,a}$ 且 $\sum_a\pi_{\theta,i,a}=1$,它便退化为随噪声加权的交叉熵,加上参数无关项。这个推导说明:Absorb 的 token 预测与掩码语言建模密切相关;SEDD 进一步要求这些预测具有正确的时间尺度,能够组成反向跳转过程并对应似然界。此段为依据原文机制的教学推导,不是论文另报的一组实验。
三:实验——先分清被测量的对象
3.1 三种指标回答三类问题
| 指标 | 对什么打分 | 方向与意义 |
|---|---|---|
| BPC / 模型困惑度 | 模型对真实测试文本赋予的概率 | 越低越好,衡量数据分布建模 |
| Generative perplexity | GPT-2 large 对被评模型生成样本打分 | 越低表示样本在评估器下越典型;对采样分布改动敏感 |
| MAUVE | 生成文本集合与真实文本集合的分布比较 | 越高越好,论文用于条件生成的质量与覆盖比较 |
对 $d$ 个 token,模型困惑度为 $\exp[-\log p_\theta(\boldsymbol x)/d]$;BPC 则将对数换成以 2 为底并按字符计数。生成困惑度中的 $p$ 来自固定评估器,而非 SEDD 自身。降低温度或 nucleus sampling 会集中概率质量,从而影响生成困惑度;作者因此在无条件实验中比较未经此类退火的样本。(Sec. 5.3.1,PDF p. 7)
3.2 模型和训练设置
SEDD 使用带时间条件的 encoder-only Transformer:双向注意力、RoPE、adaLN-zero,时间输入实际用总噪声 $\bar\sigma(t)$,输出经指数化保证正值。层数、隐藏维度、注意力头数与对应 GPT-2 规模匹配。
| 配置 | 原文报告 |
|---|---|
| Small 非嵌入参数 | SEDD 约 90M;GPT-2 约 86M |
| Medium 非嵌入参数 | SEDD 约 320M;GPT-2 约 304M |
| 输入/输出词矩阵 | SEDD 分开设置,不能只用非嵌入参数数目当总参数 |
| Batch size / 学习率 | 512 / $3\times10^{-4}$ |
| Warmup / 梯度裁剪 / EMA | 2000 次迭代 / 范数 1 / 0.9999 |
| 训练硬件 | 8 张 A100 80GB 或 16 张 A100 40GB |
语言建模通常采用句子打包;text8 按此前协议随机抽取连续子序列。作者没有系统调参,噪声日程之外的权重设计也不是本文的主要搜索对象。(Sec. 5.1,PDF p. 5;Appendix C.2–C.4,PDF pp. 15–16)
3.3 三组似然实验不能合并成一个训练设置
- text8:字符级数据,沿用 D3PM 等工作的规模与数据划分,检验离散密度建模。
- 1BW 专项训练:沿用 DiffusionBERT 的分词和配置,以接近 GPT-2 small 的规模比较,并训练一个自回归 Transformer。
- GPT-2 零样本任务:SEDD 在 OpenWebText 训练,对比使用原始 WebText 训练的公开 GPT-2;small 规模的 D3PM、PLAID 则在作者的架构与训练配置下重训。
第三组不是完全相同语料、完全相同参数量的对照实验。它检验的是在所报告训练条件下,非自回归模型能否取得有竞争力的零样本困惑度。(Sec. 5.2,PDF pp. 5–6;Appendix C.5,PDF p. 16)
四:结果——逐项看收益来自哪里
4.1 text8:报告的非自回归 BPC 最低
| 方法 | BPC $\downarrow$ |
|---|---|
| 自回归 Transformer | 1.23 |
| Discrete Flow(含自回归底座) | 1.23 |
| MAC | $\le1.40$ |
| BFN | $\le1.41$ |
| D3PM Uniform | $\le1.61$ |
| D3PM Absorb | $\le1.45$ |
| SEDD Uniform | $\le1.47$ |
| SEDD Absorb | $\le1.39$ |
来源:Table 2,PDF p. 6,节选相关行。SEDD Absorb 比 D3PM Absorb 的报告上界低 0.06 bit/character,略优于 MAC;但与自回归 1.23 仍差 0.16 bit/character。这里应讨论字符编码代价,不能把 BPC 的绝对差当成困惑度百分比。
4.2 1BW:与先前扩散模型的差距显著缩小
| 方法 | 测试困惑度 $\downarrow$ |
|---|---|
| 自回归 Transformer | 31.98 |
| D3PM Absorb | $\le77.50$ |
| Diffusion-LM | $\le118.62$ |
| BERT-Mouth | $\le142.89$ |
| DiffusionBERT | $\le63.78$ |
| SEDD Uniform | $\le40.25$ |
| SEDD Absorb | $\le32.79$ |
来源:Table 3,PDF p. 6;此处是 1BW 专项训练,区别于下一节的零样本 1BW。
对报告数值作比较,SEDD Absorb 比 D3PM Absorb 低约 57.7%,比 DiffusionBERT 低约 48.6%。后者约为 1.945 倍比值,所以原表注“至少 2 倍”是概括性近似。它与自回归的报告值相差 0.81;由于扩散给的是上界,可称接近,但无法由两个数确定精确似然是否相等。不同扩散模型间比较的也是各自上界值,可能包含界松紧程度的差异。
4.3 GPT-2 零样本:两种规模均在 3/5 个数据集上更好
| 数据集 | GPT-2 Small | SEDD Absorb Small | GPT-2 Medium | SEDD Absorb Medium |
|---|---|---|---|---|
| LAMBADA | 45.04 | $\le50.92$ | 35.66 | $\le42.77$ |
| WikiText2 | 42.43 | $\le41.84$ | 31.80 | $\le31.04$ |
| PTB | 138.43 | $\le114.24$ | 123.14 | $\le87.12$ |
| WikiText103 | 41.60 | $\le40.62$ | 31.39 | $\le29.98$ |
| 1BW | 75.20 | $\le79.29$ | 55.72 | $\le61.19$ |
来源:Table 1,PDF p. 6;困惑度越低越好。
最大改进发生在 PTB:small 的报告值下降约 17.5%,medium 下降约 29.3%。LAMBADA 和 1BW 上 GPT-2 的报告值更低。对于 SEDD 上界低于 GPT-2 精确值的条目,其证据比“两个上界之间比较”更直接;若 SEDD 上界更高,则尚不能确定其真实困惑度的排序。
同表 small 扩散基线如下,可看出 SEDD Absorb 在所有五个数据集上都有更低的报告值。
| 数据集 | D3PM | PLAID | SEDD Uniform | SEDD Absorb |
|---|---|---|---|---|
| LAMBADA | $\le93.47$ | $\le57.28$ | $\le65.40$ | $\le50.92$ |
| WikiText2 | $\le77.28$ | $\le51.80$ | $\le50.27$ | $\le41.84$ |
| PTB | $\le200.82$ | $\le142.60$ | $\le140.12$ | $\le114.24$ |
| WikiText103 | $\le75.16$ | $\le50.86$ | $\le49.60$ | $\le40.62$ |
| 1BW | $\le138.92$ | $\le91.12$ | $\le101.37$ | $\le79.29$ |
评估协议有三个会改变读数的条件。第一,不使用滑动窗口上下文,故不能与原版 GPT-2 报告直接混比。第二,除 1BW 外作者重算了 GPT-2 的似然;1BW 因公开实现的异常而沿用已有值。第三,附录 C.6 说明 WikiText2 使用 train split,因为它与 WikiText103 共用 test split。因此这里的五列不是统一意义下的五个独立测试集。(Sec. 5.2.3,PDF p. 6;Appendix C.6,PDF p. 16)
4.4 无条件生成:采样步数成为质量调节钮
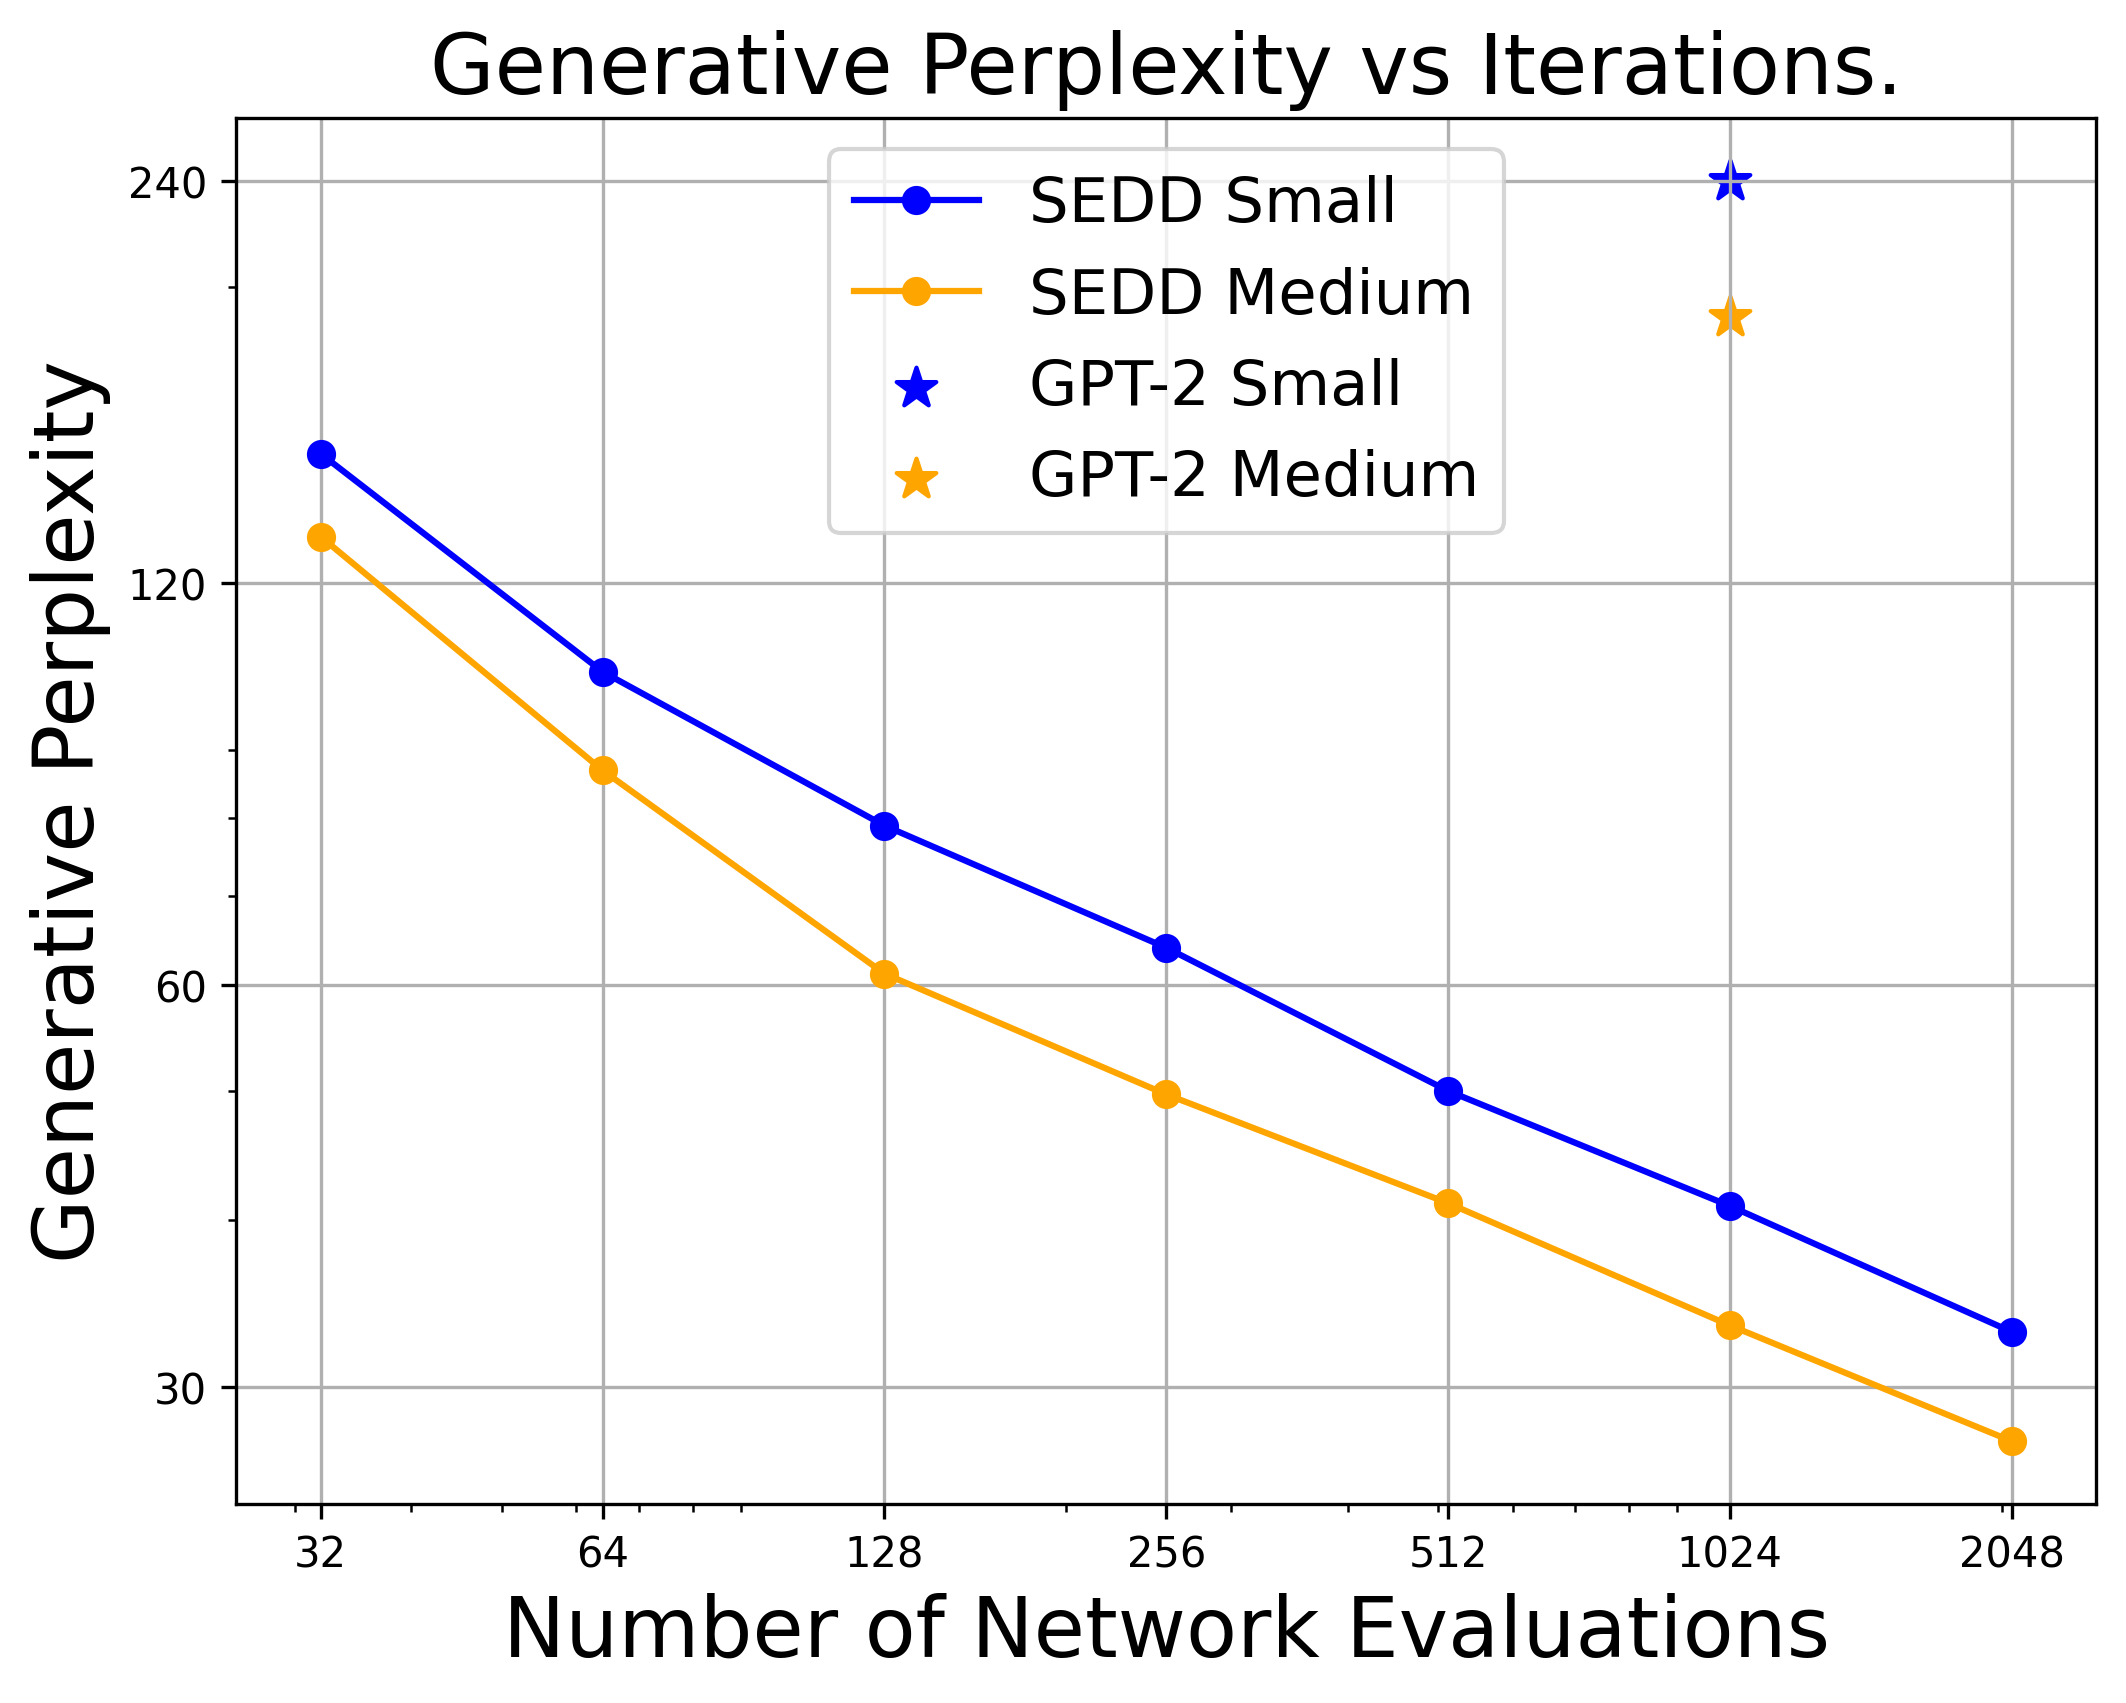
来源:原 Fig. 1(a),PDF p. 7;保留作者原图。
横轴是网络调用次数,纵轴是 GPT-2 large 评估的生成困惑度;图采用对数刻度。蓝色为 small、橙色为 medium;圆点连线是 SEDD Absorb,星号是 GPT-2。每个模型生成 1000 段长度为 1024 的文本,均不使用温度缩放等分布退火。SEDD 用 Tweedie 采样,步数从 32 到 2048。(Sec. 5.3.1,PDF p. 7;Appendix C.7,PDF p. 16)
随着步数增加,Absorb 的曲线近似在双对数坐标下线性下降。原文报告:32 步便能达到或超过未经退火 GPT-2 的这项质量,调用次数为 GPT-2 的 1/32;2048 步时,GPT-2 与 SEDD 的生成困惑度之比约为 6–8,即 SEDD 的值约为 GPT-2 的 $1/6$ 至 $1/8$。后一个比较使用更多采样迭代,不能与前一个比较合并为“同时加速 32 倍且质量提高 8 倍”。
实际耗时的含义:GPT-2 有 KV cache,每次主要计算一个新 token;SEDD 每次更新整段。作者在未经充分优化的实现中观察到,大约 100 步的 SEDD 与自回归采样耗时相近,而不保留 KV cache 使可用 batch size 约增至 4–6 倍。这是特定实现观察,不能由调用次数直接推出延迟或吞吐。(Sec. 6,PDF pp. 8–9)
生成困惑度反映样本在评估器下的典型程度。原 Fig. 1 的样例和附录长文本仍可见逻辑、实体关系及语法问题;例如 Table 4 的弓箭文本在量程描述上自相矛盾。因此,这里的收益应理解为相对生成分布质量改善,而非文本事实正确性的测量。
4.5 条件生成:无需额外条件训练即可利用不同位置的提示
| 方法 | 分布退火 | MAUVE $\uparrow$ |
|---|---|---|
| GPT-2 | nucleus,$p=0.95$ | 0.955 |
| GPT-2 | 无 | 0.802 |
| SSD-LM | logit threshold,0.95 | 0.919 |
| SSD-LM | 无 | 0.312 |
| SEDD Standard | 无 | 0.957 |
| SEDD Infill | 无 | 0.942 |
来源:Table 5,PDF p. 8。
这里全部是 medium 规模模型。每个真实样本生成 5 次,共比较 5000 个生成样本与 1000 个真实样本;条件 token 共 50 个,生成 50 个。Standard 使用前 50 个 token 续写;Infill 使用前 25 个和后 25 个 token,填中间 50 个。(Appendix C.8,PDF p. 16)
SEDD Standard 的 0.957 与 GPT-2 nucleus 的 0.955 很接近,表中没有给出误差条,不宜把 0.002 的差异写成稳定的大幅领先。更实质的发现是:SEDD 不进行分布退火就达到这一水平,且能在同一模型上改用双侧提示,MAUVE 为 0.942。Standard 与 Infill 看到的上下文位置不同,虽然提示数量相同,却不是完全相同的信息条件。
4.6 附录消融:损失和噪声类型都很重要
把 score entropy 换回平方误差:作者保留 $Q_t$ 权重,仅替换损失项,在 GPT-2 规模实验中报告似然损失约高 3–4 倍、困惑度约高 10000 倍。由于困惑度是平均负对数似然的指数,两个倍率本就不应相等。这一结果支持本论文对损失几何的重视;附录只给出概括数字,没有逐配置明细或误差条。(Appendix D.1,PDF p. 17)
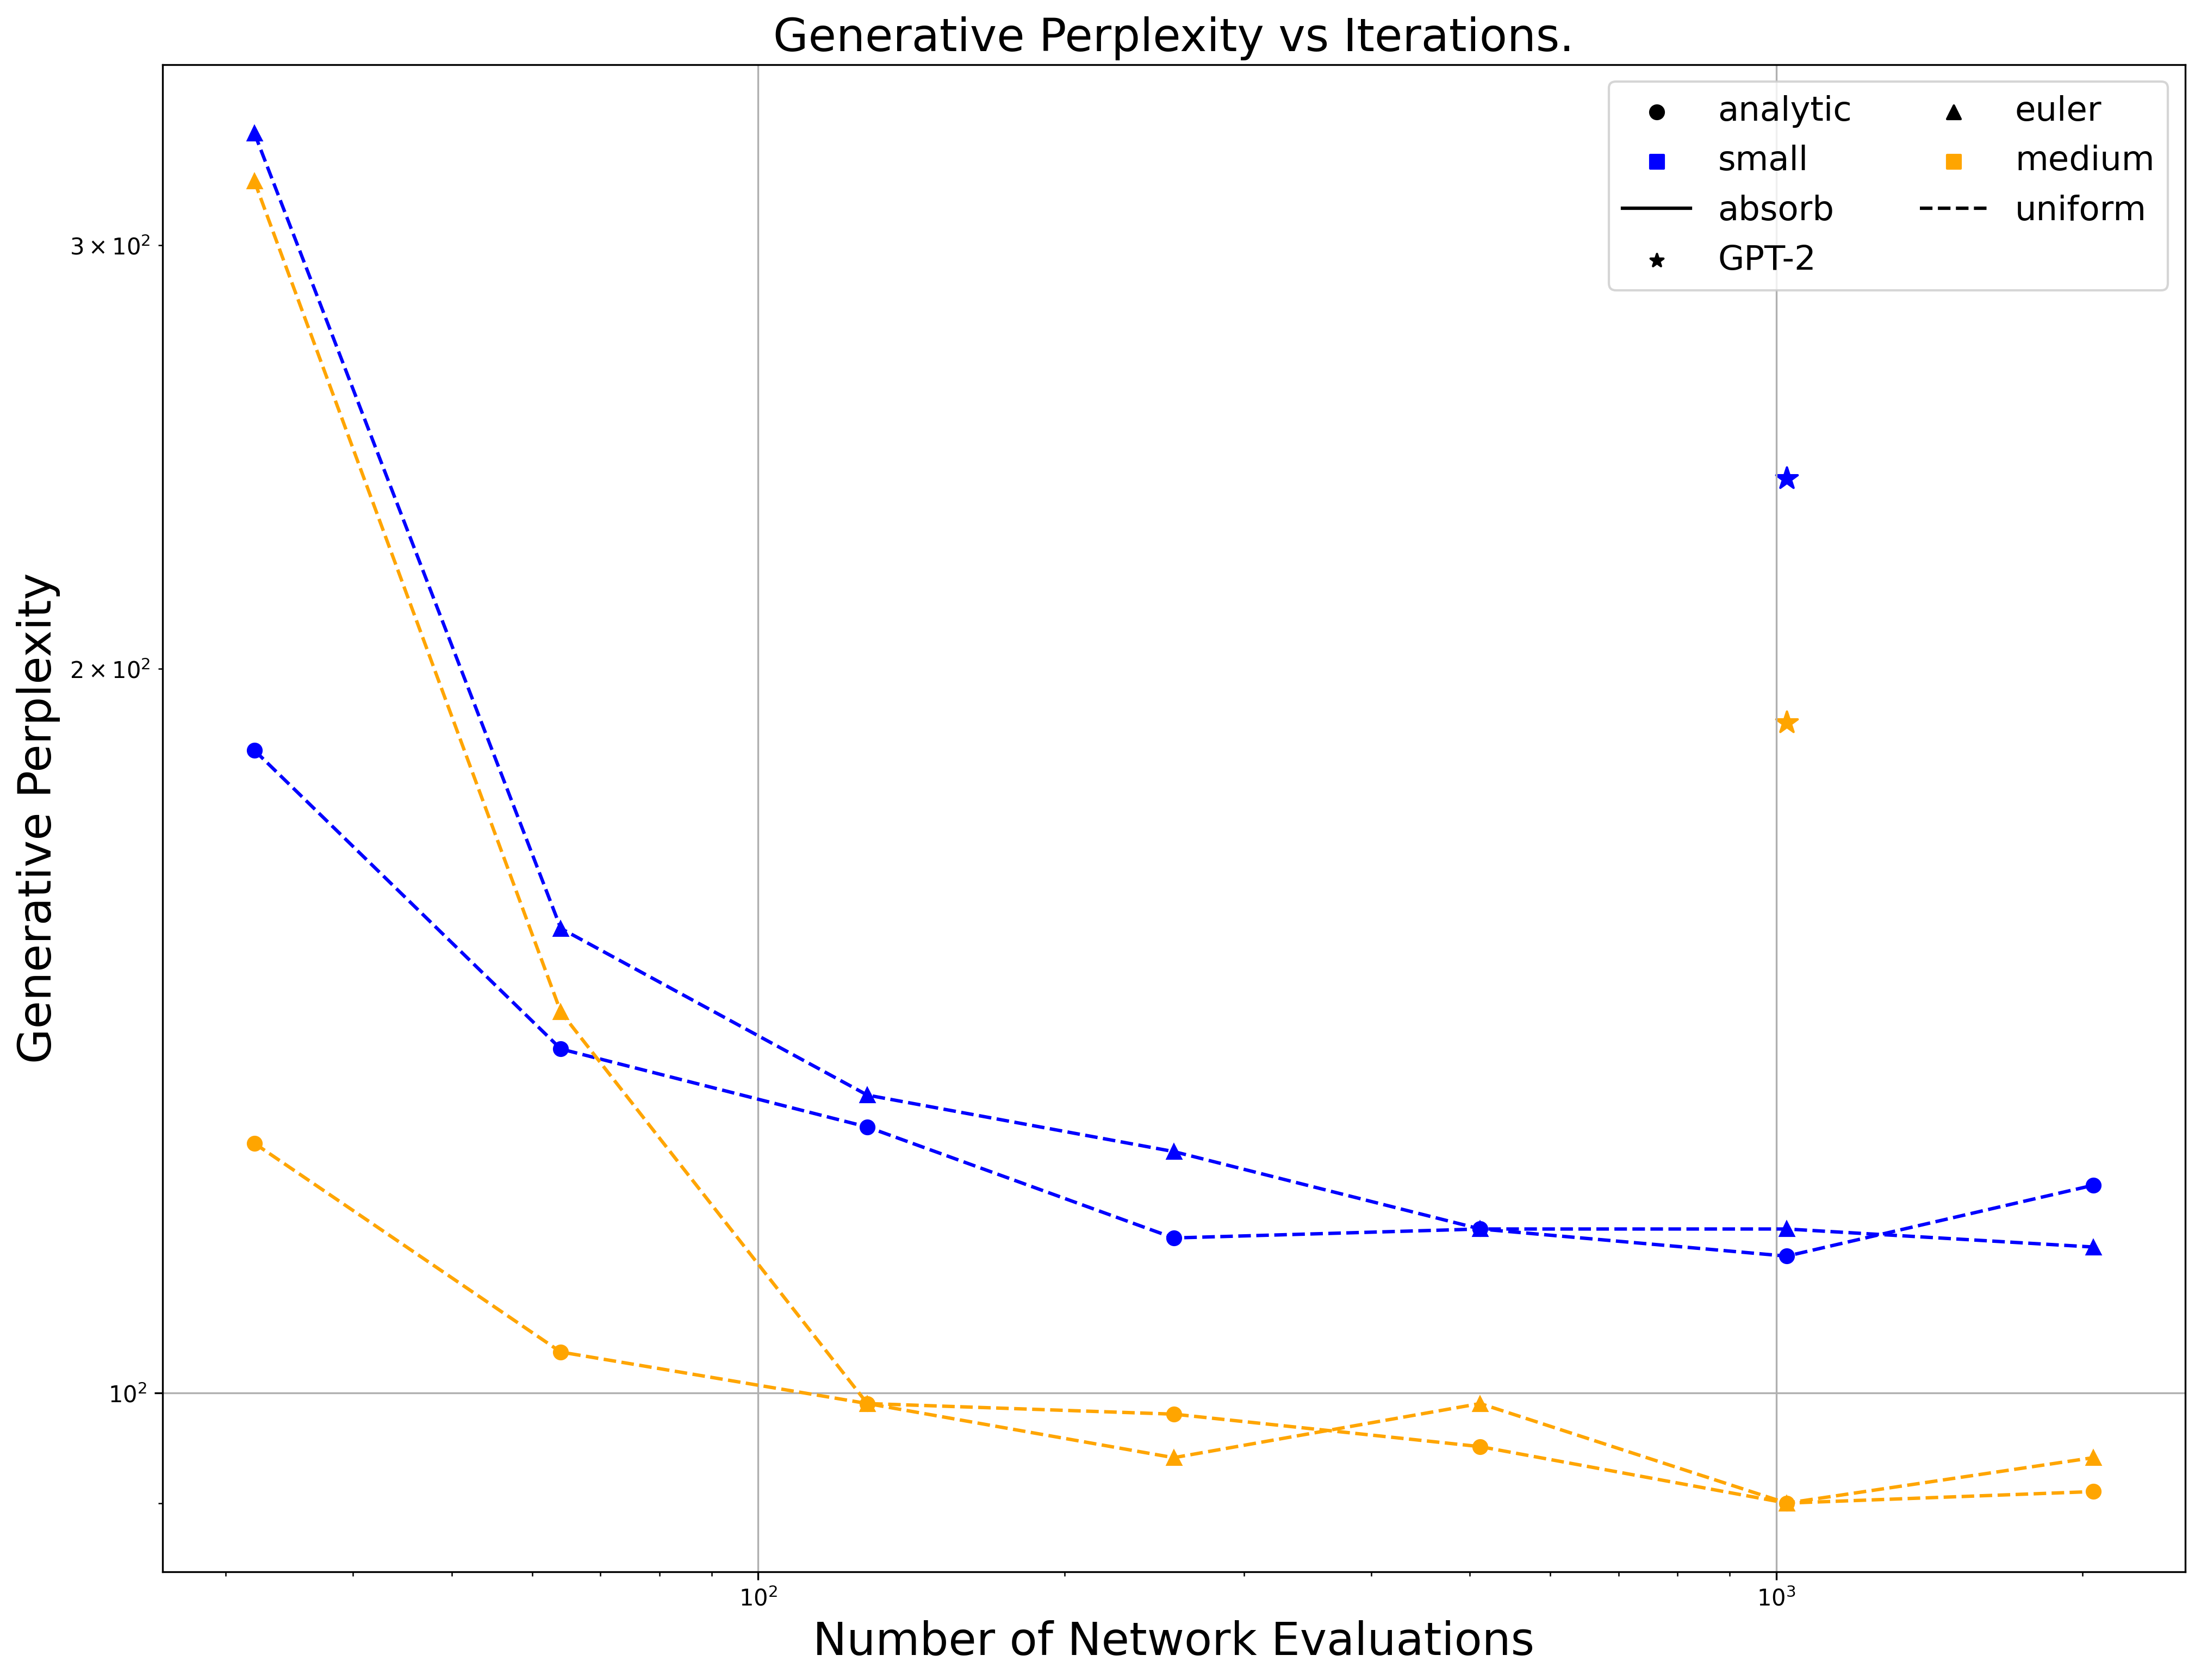
来源:原 Fig. 2,PDF p. 17。
横轴仍为网络调用次数、纵轴为生成困惑度;蓝、橙分别对应 small、medium,圆点是 analytic/Tweedie,三角是 Euler,虚线为 Uniform。图例保留了 Absorb 实线标签,但这个面板主要显示 Uniform 的曲线。
Uniform 在较多步时出现明显平台,无法复现 Absorb 随步数持续改善的曲线。Tweedie 在少步数时尤其有利,多步时两者差距缩小,也并非每个点都更优。附录 D.2 还说明,重训的 D3PM 和 PLAID 的生成质量差于 SEDD Absorb、却略好于 SEDD Uniform;因此不能把 Absorb 的优势泛化到所有 SEDD 噪声设置。(PDF pp. 17–18)
五:结论——这篇论文最值得带走什么
第一,建模对象与损失必须一起设计。 反向马尔可夫链需要的是正值、未归一化的概率比。Score entropy 对这些比率提供合适的优化信号,去噪等价式又把它变成一次前向即可估计的训练目标。它同时改变了小 score 的梯度行为,并与路径空间的似然界一致。
第二,前向过程的稀疏结构决定需要学习哪些信息。 独立 token 加噪使生成器只依赖单位置替换比率,而网络仍通过双向注意力利用整段上下文。这个组合避免了显式表示整个序列分布,又保留了全局语言依赖。
第三,结果中最有说服力的是 Absorb 的综合表现。 它同时改善报告的似然上界、生成质量和条件生成灵活性;Uniform 的生成平台说明噪声选择仍是模型设计的一部分。与 GPT-2 的比较应保留语料、参数量、评估 split、上界和采样协议等条件。
对实际使用而言,需要权衡的是整段反复计算的成本、采样步数、固定生成长度和所需条件控制方式。论文展示了离散扩散在 GPT-2 规模语言建模上的竞争力;如何随更大模型与数据规模变化,以及如何进一步降低整段迭代成本,是作者提出但本篇尚未解决的问题。(Sec. 6–7,PDF pp. 8–9)
参考与材料
- Aaron Lou, Chenlin Meng, Stefano Ermon. Discrete Diffusion Modeling by Estimating the Ratios of the Data Distribution, arXiv v3. 本笔记的实验数值、命题和原图均来自这一版本。
- 本地原论文 PDF;同版本作者 TeX 主文件。
- 作者代码仓库(原文所列项目链接)。