MemGPT:把长上下文问题改写成操作系统的内存管理
论文: MemGPT: Towards LLMs as Operating Systems
作者: Charles Packer、Sarah Wooders、Kevin Lin、Vivian Fang、Shishir G. Patil、Ion Stoica、Joseph E. Gonzalez
arXiv: 2310.08560 v2,2024-02-12 修订;本次阅读使用 v2,获取于 2026-11-10。
原文: arXiv PDF
- 发表: 截至 2026-11-10 未查到正式会议或期刊发表记录。arXiv v2 未列 Journal reference,UC Berkeley Sky Computing Lab 项目页将其列为 CoRR(arXiv preprint)。arXiv 记录 · UC Berkeley 项目页
- 代码: 作者项目页提供实验代码与数据链接;旧的 cpacker/MemGPT 地址目前重定向到 Letta 官方仓库,项目现名 Letta,代码已演进。作者项目页
论文总览
MemGPT 把有限上下文视为类似 RAM 的快速但稀缺资源,再把原始聊天记录和文档放到上下文之外。LLM 通过函数调用决定何时整理工作记忆、何时搜索外部数据、以及何时继续调用函数。上下文逼近容量上限时,队列管理器先发出 memory-pressure 提示;到达 flush 阈值后,再移出较旧消息、生成递归摘要,并把完整消息保留在 recall storage 中。
核心贡献是将虚拟内存式分页、分层存储和事件控制流组合成一个可由 LLM 自主操作的上下文管理系统。每次模型推理仍受原有上下文窗口限制;“近似无限上下文”指系统能在跨越多个推理轮次时,把外部信息分页到窗口中,而非一次把无限文本塞进提示词。
作者用两类对照实验支持这个设计:在多轮聊天记忆中,MemGPT 提高了回忆历史细节的准确率;在文档问答和嵌套键值查询中,函数调用支持模型反复检索,缓解一次性检索或上下文拼接的限制。结果也显示效果依赖底层模型的函数调用能力与是否继续搜索。
结构地图
| 原文位置 | 内容与证据 | PDF 页 |
|---|---|---|
| Abstract;Sec. 1 Introduction | 问题设定、虚拟上下文管理思路 | 1–2 |
| Sec. 2 MemGPT | 主上下文、存储层、队列管理、函数执行与控制流;Fig. 1–4 | 2–4 |
| Sec. 3 Experiments | 聊天记忆、对话开场、文档问答、嵌套 KV;Tables 2–3、Figs. 5–8 | 4–8 |
| Sec. 4 Related Work;Sec. 5 Conclusion | 与长上下文、RAG、LLM agent 的关系及结论 | 8 |
| References | 参考文献 | 9–10 |
| Sec. 6 Appendix | 任务提示词、数据生成提示词和 LLM judge 说明 | 11–13 |
一:动机
论文针对固定上下文窗口与长期任务之间的错配。长对话、长文档和跨文档推理都会让所需信息超过单次输入容量。直接扩大 Transformer 窗口会提高计算和内存成本;作者还援引“lost in the middle”现象,指出更长的上下文并不保证模型能有效利用其中所有位置的信息。
MemGPT 的新思路不是改造 Transformer,而是借鉴操作系统虚拟内存:应用看到的虚拟内存可以大于物理 RAM,操作系统通过分页把当前需要的数据载入 RAM。对应到 LLM,当前提示词是主存,外部数据库是磁盘,函数调用承担读写与分页。与一次性检索不同,模型可以在同一任务中连续检索、把结果送入上下文、再决定下一步检索。
二:方法
2.1 内存层次与职责
| 部分 | 位置 | 写入/读取方式 | 主要用途 |
|---|---|---|---|
| System instructions | 主上下文,静态 | 只读 | 说明 MemGPT 的控制流程、记忆层用途与函数接口 |
| Working context | 主上下文,固定大小 | LLM 通过函数读写 | 保留聊天中稳定、当前重要的事实、偏好和 persona 信息 |
| FIFO queue | 主上下文 | 队列管理器写入;LLM 可通过函数处理其中信息 | 保存近期用户/助手消息、系统提示和函数调用记录;首项可放被移出消息的递归摘要 |
| Recall storage | 外部上下文 | 队列管理器持久写入,函数检索 | 保存完整消息记录,支持历史对话搜索和分页回填 |
| Archival storage | 外部上下文 | LLM 通过函数读写 | 保存任意长度文本或文档;可由向量检索等索引实现 |
这一区分解决两个不同问题:working context 让常用个人事实易于直接使用;recall storage 保留原始聊天细节;archival storage 支持对文档集合进行搜索。外部信息只有被明确分页到主上下文后,模型才能在该轮推理中使用。
2.2 队列管理与控制流
作者描述的执行循环可以概括为:
- 一个事件触发模型推理。事件可以是用户消息、上下文容量警告、上传完成通知或定时事件;解析后的内容加入 FIFO queue。
- 队列管理器把新输入和模型输出持久写入 recall storage,并把主上下文提交给 LLM。
- 当 token 数超过 warning threshold,系统插入 memory-pressure 消息,提示模型在即将清理前把重要内容写入 working context 或 archival storage。论文用约 70% 窗口容量作示例。
- 当输入超过 flush threshold,队列管理器移出一批旧消息并生成递归摘要,释放当前上下文空间;完整历史仍留在 recall storage。约 100% 容量触发、移出约 50% 是文中的示例设置,不是适用于所有模型的固定参数。
- LLM 可以输出函数调用。执行器校验参数、读写存储,再把结果或运行错误放回上下文。若调用带有 request_heartbeat=true,MemGPT 立即再次运行模型,允许模型连续搜索多页结果;否则函数调用 yield,等待下一个外部事件。
系统指令、自然语言函数说明和 token 警告共同引导模型管理记忆。论文强调模型可以自主决定保存什么、何时搜索;队列管理器负责持久化、容量计数、驱逐和递归摘要。分页检索也会考虑上下文容量,避免把一页结果本身塞爆窗口。
2.3 两个直观例子
- 聊天记忆: 旧消息被挤出 FIFO 后仍保存在 recall storage。用户问到生日或旧活动时,MemGPT 可以先搜索历史,再把相关片段附回当前上下文;稳定事实也可更新到 working context。Fig. 1–2 展示写入与检索,Fig. 4 展示将“男友 James”改为“前男友 James”的工作记忆修订(PDF pp. 2、4)。
- 文档问答: 文档集合放在 archival storage。模型发出搜索函数,系统分页返回相关片段;模型可依据首批结果继续查询下一页,最终回答并引用命中文档。Fig. 3 给出组件数据流,Fig. 6 展示分页搜索例子(PDF pp. 3、6)。
该机制把信息访问责任部分交给模型:它不仅生成答案,还需判断应读写什么并生成有效函数参数。因此底层模型的工具调用能力、提示词是否促使它持续检索,直接影响 MemGPT 的效果。
三:实验
3.1 多轮聊天:Deep Memory Retrieval
问题。 模型能否回答只能从过去对话中回忆的窄问题?数据来自 Multi-Session Chat(MSC):原始数据有五轮对话,作者另构造第六轮问答,问题由单独的 LLM 生成,目标信息必须来自前五轮聊天而非 persona 摘要。
比较。 固定上下文基线看到前五轮的有损摘要;MemGPT 可对完整历史进行分页搜索。比较 GPT-3.5 Turbo、GPT-4 和 GPT-4 Turbo 作为底座,指标是回答准确率与 ROUGE-L recall。作者使用 LLM judge 判断答案是否触及 gold answer 的主题;ROUGE-L 使用 recall 以适应模型回答比短 gold 答案更长的情况。
| 底座模型 | 固定上下文准确率 | + MemGPT | 固定上下文 ROUGE-L recall | + MemGPT |
|---|---|---|---|---|
| GPT-3.5 Turbo | 38.7% | 66.9% | 0.394 | 0.629 |
| GPT-4 | 32.1% | 92.5% | 0.296 | 0.814 |
| GPT-4 Turbo | 35.3% | 93.4% | 0.359 | 0.827 |
三个底座都因 MemGPT 而提高;GPT-4 与 GPT-4 Turbo 的准确率分别提升 60.4 和 58.1 个百分点。证据支持“可搜索的完整历史”比单个压缩摘要更适合此类细节回忆。来源:Sec. 3.1,Table 2,PDF p. 5。
3.2 对话开场:长期信息是否用于个性化
开场任务检验模型能否在新一轮对话中主动提及此前积累的用户信息。作者用 persona 标签相似度 SIM-1 / SIM-3,以及与人工开场的相似度 SIM-H 进行评估;此处报告的是 MemGPT 配不同底座模型的结果。
| 方法 | SIM-1 ↑ | SIM-3 ↑ | SIM-H ↑ |
|---|---|---|---|
| 人工开场 | 0.800 | 0.800 | 1.000 |
| MemGPT + GPT-3.5 Turbo | 0.830 | 0.812 | 0.817 |
| MemGPT + GPT-4 | 0.868 | 0.843 | 0.773 |
| MemGPT + GPT-4 Turbo | 0.857 | 0.828 | 0.767 |
MemGPT 生成的开场与 persona 标签的相似度超过人工开场基准,但与人工开场本身的相似度低于人工行。因而这些结果说明 MemGPT 能覆盖更多 persona 信息,不能直接解释为用户主观偏好或“更 engaging”。来源:Sec. 3.1,Table 3,PDF p. 5。
3.3 多文档问答:迭代检索能否抵消 top-K 截断
任务与设置。 作者从 NaturalQuestions-Open 选取 50 个问题,使用 2018 年末的 Wikipedia dump。MemGPT 和基线使用同一个 text-embedding-ada-002 向量检索器;MemGPT 将文档集合载入 PostgreSQL / pgvector,以 HNSW 索引搜索,固定上下文基线则一次性把 top-K 文档交给 LLM。答案由 LLM judge 评分,并要求答案能从返回文本中得到支持。
结果。 Fig. 5 横轴是提供/检索的文档数,纵轴为准确率。MemGPT + GPT-4 / GPT-4 Turbo 在图中约维持 0.72,MemGPT + GPT-3.5 Turbo 约为 0.40;固定上下文基线随 K 变化,文档截断加重时性能会下降。机制上的差异是 MemGPT 可以多次调用检索器,而基线无法看到超过一次 top-K 输入的材料。来源:Sec. 3.2.1,Fig. 5,PDF p. 6。
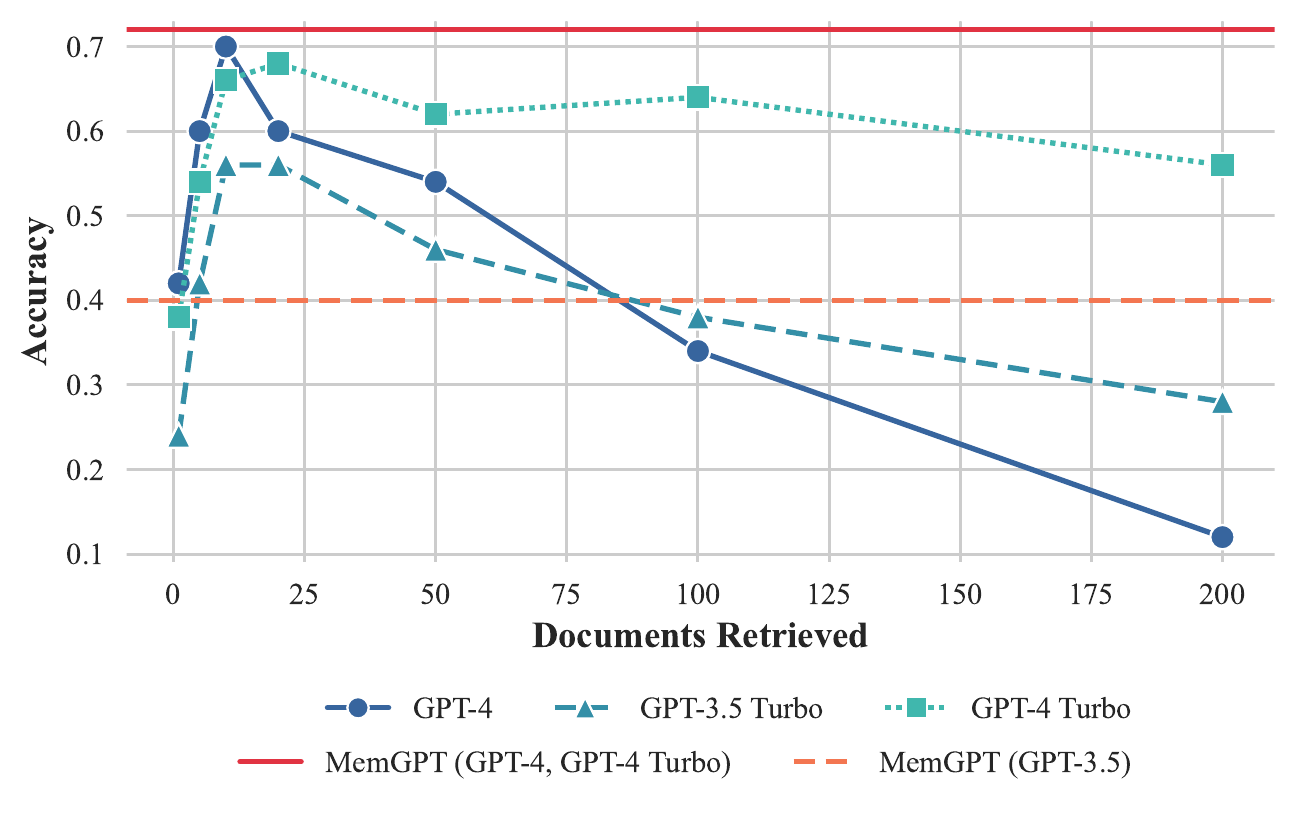
图中 GPT-4 与 GPT-4 Turbo 的 MemGPT 曲线重合;GPT-3.5 Turbo 的曲线较低。作者指出,embedding 排名可能把 gold 文档排得很靠后,MemGPT 有时会在遍历完结果前停止分页;底座 GPT-3.5 的函数调用能力也限制表现。此任务因此同时测到存储/检索机制和模型是否愿意持续调用工具。
3.4 嵌套 KV:多步跨记录检索
任务与设置。 合成键值表中,键和值均为 128-bit UUID;某个值也可能是下一次查询的键,必须重复查找直到找到不再是键的最终值。实验使用 140 对(约 8K tokens),把嵌套深度从 0 变化到 4,并抽取 30 种键顺序配置。
结果。 GPT-3.5 固定上下文基线在深度 1 就降到 0;GPT-4 与 GPT-4 Turbo 基线在深度 3 到 0。MemGPT + GPT-4 在 Fig. 7 显示至深度 3 仍为 1.0;MemGPT + GPT-4 Turbo 从深度 2 开始下滑(深度 2 约 0.7,深度 3 约 0.6),说明工具链本身仍受底座模型与多次查找能力影响。来源:Sec. 3.2.2,Fig. 7,PDF p. 7。
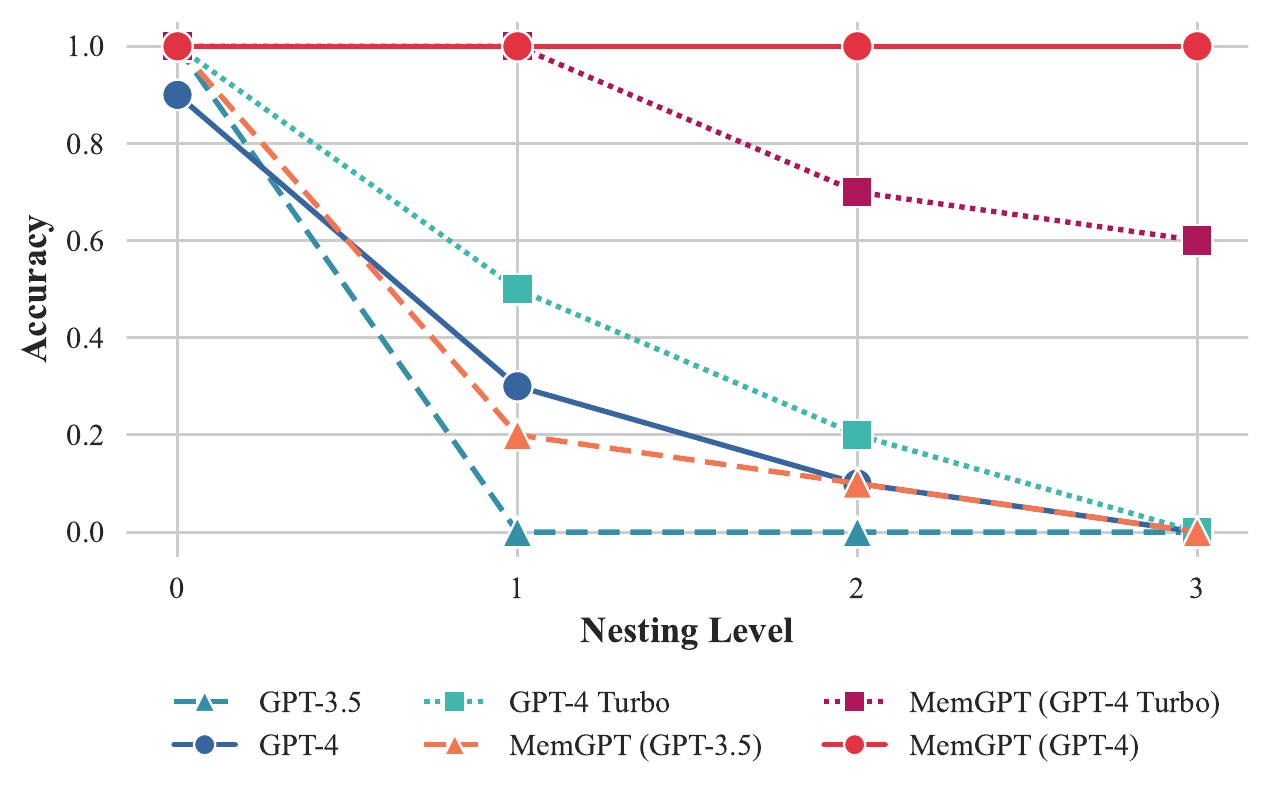
这个任务把核心能力隔离得更清楚:答案不在一次性输入的单段上下文中,而在一串依赖前一结果的查询中;heartbeat 让模型能在同一回答过程中继续调用搜索。结果是合成任务上的多跳检索证据,并非开放域推理的完整评估。
四:结果的合并解读
实验共同支持两点。首先,原始历史保留在外部存储并按需分页,可以补足固定上下文摘要容易丢失的细节。其次,模型能基于函数结果继续查询时,外部记忆才成为可操作的多步推理资源;嵌套 KV 和文档 QA 都体现了这一点。
这套方案的行为不是纯粹由数据库决定。LLM 要从提示词中学会何时写入、何时检索和何时继续分页;固定的外部存储只保证信息可取回,不保证模型一定会取回。文档 QA 中过早停止分页、GPT-3.5 上的退化,以及 GPT-4 Turbo 在嵌套 KV 中较弱的 MemGPT 结果,均显示控制策略与底座模型很重要。
五:结论与适用范围
MemGPT 的架构贡献是把固定窗口上的“记忆”重新表述为虚拟上下文管理:把近期工作集留在提示词里,把完整历史和文档存到外部,再由模型通过函数调用分页读写。此设计既保留了现成固定窗口 LLM,也允许单个任务跨多个函数调用逐步积累所需信息。
结果范围应按论文协议理解:聊天实验使用 MSC 上构造的深记忆问答和开场任务;文档 QA 只抽样 50 个 NaturalQuestions 问题;嵌套 KV 是 140 对 UUID 的合成任务;若干评判依赖 LLM judge 或相似度指标。论文没有用这些实验证明所有长任务都会“无限扩展”,但它展示了内存分页和事件控制流如何把超窗任务拆为多个可执行的上下文步骤。
参考来源
- Packer et al., arXiv:2310.08560v2(本文分析的原文版本)。
- MemGPT 作者项目页(论文、代码与数据入口)。
- UC Berkeley Sky Computing Lab 项目页(项目说明与 CoRR 发表信息)。
- 官方代码仓库入口(现重定向至 Letta)。