Data Distributional Properties Drive Emergent In-Context Learning in Transformers:中文研读笔记
**一句话要点:**在本文的受控图像序列实验中,Transformer 是否学会从上下文建立新关联,取决于训练数据的局部重复、类别数量和映射变化;适当的 Zipf 频率分布还能让这种能力与常见类别的参数记忆共存,但完整输出空间下的表现存在明显限制。
- **作者(按 PDF 署名):**Stephanie C. Y. Chan、Adam Santoro、Andrew K. Lampinen、Jane X. Wang、Aaditya K. Singh、Pierre H. Richemond、James L. McClelland、Felix Hill。arXiv 元数据另以 Aaditya Singh 和 Jay McClelland 表示其中两位作者。
- 论文版本:arXiv:2205.05055v6,2022-11-17 修订;arXiv 页面注明 NeurIPS 2022 Oral。
- **获取与研读日期:**2026-09-29;本次成品修订 r1。目录中的
ICL-Data是归档主题名,作者没有提出同名算法。 - 原始材料:版本固定的 PDF、本地 PDF、作者主 TeX、源码获取记录。PDF 与源码均已成功下载并核对。
- **阅读范围:**正文 Sec. 1–4、全部主要图 1–7,以及附录 A、B、C.1–C.4 和图 8–11。主 TeX 直接包含全部实质正文与附录,没有需要递归读取的章节输入文件;
defns.tex未被主文件引用。PDF 共 18 页,本文定位均为从 1 开始的 PDF 页码,与显示的印刷页码一致。 - 配套材料:英文汇报 PDF、可编辑 Beamer TeX、图件来源与裁切坐标。没有执行作者代码、重新训练模型或复现实验;本文数值来自原文,图上估读会明确标注。
论文总览
这篇论文研究的是一个能力形成问题:模型训练时只被要求预测图像标签,为什么测试时能根据几个上下文例子,为从未见过的图像类别建立临时标签关联?作者没有引入新的注意力模块,而是控制训练数据分布,观察模型最终采用何种策略。
作者区分上下文学习(in-context learning,ICL)与参数内学习(in-weights learning,IWL)。前者在推理时读取当前序列里的示例,不更新权重;后者依赖训练期间通过梯度更新形成的图像—标签关联。注意,ICL 能力本身仍然通过训练获得,“无需梯度更新”指使用该能力进行当前任务时无需更新。
最有力的证据是:在架构和目标基本固定时,改变数据的局部重复程度、类别数量及标签稳定性,可以明显改变 ICL/IWL 的相对表现;在未见图像类别上测试,排除了仅靠记住这些测试类别映射来答题的解释。结论的有效范围是本文的 Omniglot 序列分类设置,尚不是对自然语言大模型全部 ICL 行为的机制证明。
结构地图
| 原文章节 | 在论证中的作用 | PDF 定位 |
|---|---|---|
| 1 Introduction | 从语言中的 burstiness、长尾与动态含义提出假设 | pp. 1–3;图 1 在 p. 2 |
| 2.1 The training data | 定义图像—标签序列及 bursty/non-bursty 采样 | p. 4 |
| 2.2 The model | 图像编码器、标签嵌入、因果 Transformer、查询分类损失 | p. 4 |
| 2.3 The evaluation data | 分离 ICL 与 IWL 的两套诊断协议 | pp. 4–5 |
| 3.1 What kinds of training data promote in-context learning? | 依次操纵局部重复、类别数量、标签多重性、类内变化 | pp. 5–6;图 2 p. 3、图 3 p. 4、图 4–5 p. 6 |
| 3.2 What kinds of training data enable in-context learning and in-weights learning to co-exist in the same model? | 用 Zipf 边际分布检验能力共存 | pp. 7–8;式 (1)、图 6 |
| 3.3 But architecture does matter too. | Transformer、vanilla RNN、LSTM 对照 | p. 8;图 7 |
| 4 Discussion | 总结适用范围、语言与认知启示、后续问题 | pp. 8–10 |
| A Model and training procedure: details | 训练超参数、重复次数、误差条 | p. 15 |
| B Possible extensions: Generating new image labels | 明确“新类别”与“新标签”的区别 | p. 15 |
| C.1 Architectural details;C.2 In-weights learning | 架构搜索与参数量;IWL 补充对照 | pp. 15–16;图 8 p. 16 |
| C.3 In-context evaluation on trained classes | 已见类别重映射时的 ICL | pp. 15–16;图 9 p. 17 |
| C.4 Multi-class in-context evaluation | 完整输出空间与上下文标签选择率 | p. 16;图 10–11 p. 18 |
图的位置受浮动排版影响,图 4 实际位于图 5 下方;不能按源码顺序猜测页码。
一:动机——训练目标相同,解题策略为何不同?
标准监督训练常让类别反复出现、标签长期固定。这样模型可以把关联保存在权重里。经典情节式小样本元训练则常在不同 episode 中更换类别或重新分配标签,使模型必须利用当前上下文。
自然数据介于两者之间:某个实体整体很少出现,但在一次谈话中连续被提及;同一个词也会依上下文改变含义。作者提出,这些分布特点可能已经为学习“临时建立关联”的通用策略提供了训练信号,而不需要专门使用每个 episode 全面重映射的元训练协议。(Sec. 1,pp. 1–3)
因此,“emergent”在本文里应理解为:训练没有直接采用测试时的新类别、随机二元标签任务,但测试时出现了这种迁移能力。它不表示训练数据没有经过人工设计,也不表示论文证明了随参数规模突然出现的相变。
二:方法——用两种测试分离信息来源
2.1 输入、模型与训练目标
Omniglot 原始数据有 1,623 个手写字符类别,每类 20 个样本。每个输入序列由 8 对图像—标签和最后一张查询图像组成,共 17 个 token。图像经过从头训练的 ResNet;整数标签经过嵌入层;两类表示加上正弦位置编码,送入因果 Transformer。(Sec. 2,pp. 4–5;附录 A,p. 15)
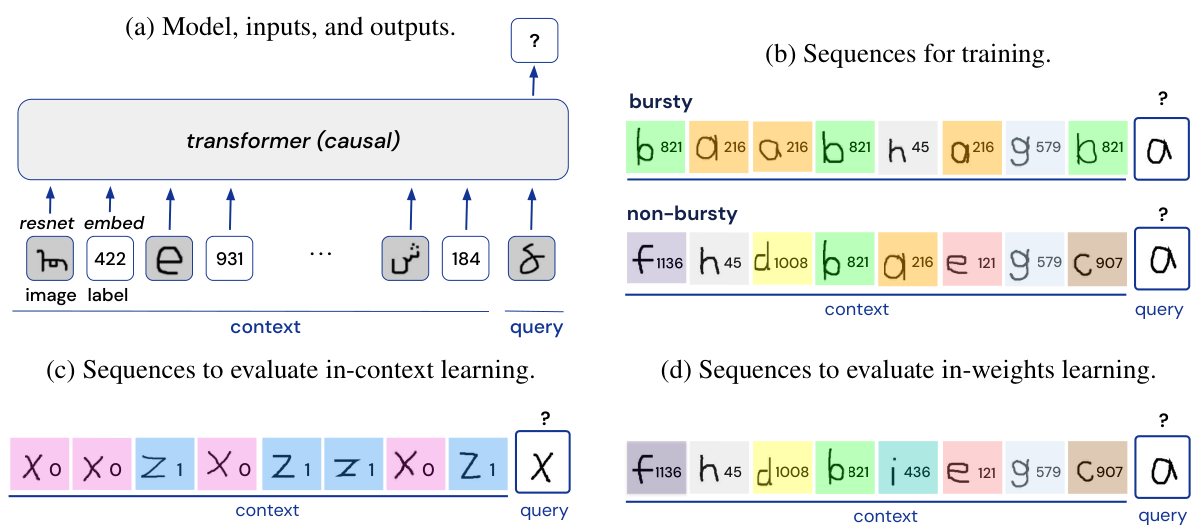
来源:原图 1,PDF p. 2,保留全部四个面板。左上为模型,右上为训练采样,左下为 ICL 测试,右下为 IWL 测试。彩色拉丁字符是作者为说明而画的示意,实际数据是 Omniglot 图像。
下面是对原文训练过程的教学形式化,不是论文新增的编号公式。令 $u_i$ 为图像、$\ell_i$ 为标签,$\mathcal C$ 为当前上下文,$K$ 为输出标签数:
输出为 $K$ 维分类分布,损失只施加在最后查询图像的正确标签上。这不是对序列每个位置施加的语言模型 next-token 损失。一般条件下图像类别与标签跨训练序列固定;标签多重性实验是明确的例外。
| 设置 | 原文报告 |
|---|---|
| 默认 Transformer | 12 层、嵌入维度 64、8 个注意力头 |
| 图像编码器 | 非预训练 ResNet,每组 2 个 block,通道组为 (16, 32, 32, 64) |
| 优化器与步数 | Adam,500,000 步 |
| 学习率 | 前 4,000 步线性 warmup 至 $3\times10^{-4}$,之后按平方根倒数衰减 |
| 计算资源 | 16 个 TPU v2 或 v3 核 |
| 随机重复 | 图 5、6 各条件 3 个 seed;其余一般实验 5 次;架构搜索另有 90 次配置运行 |
| 误差条 | 均值周围的标准差,不能当作置信区间 |
来源:附录 A、C.1,p. 15。论文正文/附录未报告 batch size、完整优化器细节与全部实验的逐次原始读数;本笔记不按惯例补填。
2.2 Bursty 序列如何构造?
在 bursty 序列的 8 个上下文样例中,查询类别出现 3 次,另一个类别也出现 3 次,以免模型只输出出现次数最多的标签。non-bursty 序列从类别集合随机均匀采样。$p(\mathrm{bursty})$ 控制整条序列来自哪种采样方式的比例,不表示“每个 token 重复的概率”。(Sec. 2.1,p. 4)
例如,教学序列可写成 A:7, B:4, A:7, C:2, B:4, D:9, A:7, B:4 → query A。答案 7 可以通过当前上下文获得,也可以通过训练期间记住 A→7 获得。在训练分布上,这两条路径往往给出同样答案,因此训练准确率本身不能区分它们。
2.3 两种评估测量的对象不同
| 协议 | 上下文与查询 | 标签规则 | 计分及随机基线 |
|---|---|---|---|
| ICL,主文 | 未见过的两类图像,各 4 个上下文样例;查询来自其中一类 | 每条序列重新随机分配为 0、1 | 只比较标签 0、1 的输出;基线 50% |
| IWL | 已训练类别;查询类别不出现在上下文中 | 保留训练时标签 | 全输出空间准确率;通常为 $1/1600=0.0625\%$ 的随机基线 |
| ICL,附录完整多分类 | 与主文 ICL 相同 | 同上 | 在全部 $K$ 个输出标签中取最大值;均匀猜测基线 $1/K$ |
来源:Sec. 2.3,pp. 4–5;附录 C.4,p. 16。两种学习能力的准确率不能作为同难度任务直接相减:它们的类别来源、可用信息和计分空间不同。
令模型的全输出 logits 为 $z\in\mathbb R^K$。两种 ICL 计分可形式化为:
这是对协议的教学表达,模型在两种计分下没有改变。比如正确答案为 1,而 $z_0=1,z_1=2,z_7=5$,二选一计分正确,完整多分类计分错误。这个区别正是理解 Zipf 结果的关键。
主文测试的是新图像类别、熟悉的标签 token。标签 0、1 训练时已见,在 Zipf 实验中还对应最常见的两个标签。生成全新标签不在实验范围内。(附录 B,p. 15)
三:实验——干预变量与对照
这是一篇分布干预实验论文,主要对照是改变数据条件或模型架构,没有一个待与现有算法比榜单的新方法。
| 实验 | 操纵变量 | 关键固定条件与比较角色 |
|---|---|---|
| 图 2:局部重复 | $p(\mathrm{bursty})\in\{0,0.5,0.9,1\}$ | 0 是均匀随机采样对照;同时测 ICL/IWL |
| 图 3:类别数量 | 100、1,600、12,800 | $p(\mathrm{bursty})=0.9$;增加类别使单类出现更稀少 |
| 图 4:标签多重性 | 每类 1、2、5、10 个候选标签 | $p(\mathrm{bursty})=0.9$;序列内标签一致,跨序列可变 |
| 图 5:类内变化 | 单张固定图、像素噪声 0.1/0.5、完整 Omniglot | 比较 $p=0.5,0.9,1$;完整类别有 20 个不同手写样本 |
| 图 6:类别频率偏斜 | Zipf 指数 0、0.5、1、1.5、2、3 | 12,800 类、$p=0.9$;区分前 10 个常见类别和其余类别的 IWL |
| 图 7–8:架构 | Transformer、vanilla RNN、LSTM | 1,600 类、$p=0.9$;同类编码器与查询分类目标;2/12 层搜索 |
| 图 9–11:评估稳健性 | 已见类别重映射、完整多分类、输出上下文标签频率 | 检查主结论是否依赖测试类别和计分方式 |
注意不要把 Zipf 实验的 12,800 类套用到架构实验;也不要把图 5 的三种 burstiness 设置写成统一 $p=0.9$。噪声图例给出 “Pixel noise 0.1/0.5”,正文只描述为高斯像素噪声;此处不额外声称它们是某种归一化单位下的方差。
四:结果——证据、解释与边界
4.1 局部重复促进 ICL,同时削弱 IWL
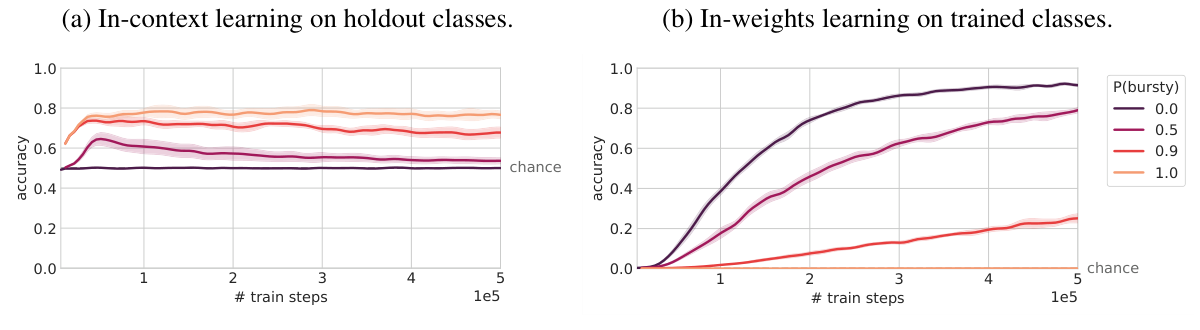
来源:图 2,PDF p. 3;解释见 Sec. 3.1,p. 5。两幅图横轴均为训练步数,纵轴为准确率;颜色是训练时 bursty 序列的比例,阴影为标准差。左图的虚线是 50%,右图的随机水平接近 0。
没有 burstiness 时,ICL 基本停留在 50%。随着 bursty 比例增加,ICL 更强;IWL 则相反。训练后段部分曲线的 ICL 下降、IWL 上升,说明增加训练时间可能让模型逐渐转向参数记忆,不能把“训练更久”默认等同于“ICL 更好”。
**解释:**局部重复让从上下文查找关联成为有用的训练策略;均匀随机采样使这种支持较少。这里是在特定采样干预下观察到的效果,没有证明任何形式的重复都必然提高 ICL。
4.2 更大的类别集合推动模型学习可复用的关联策略
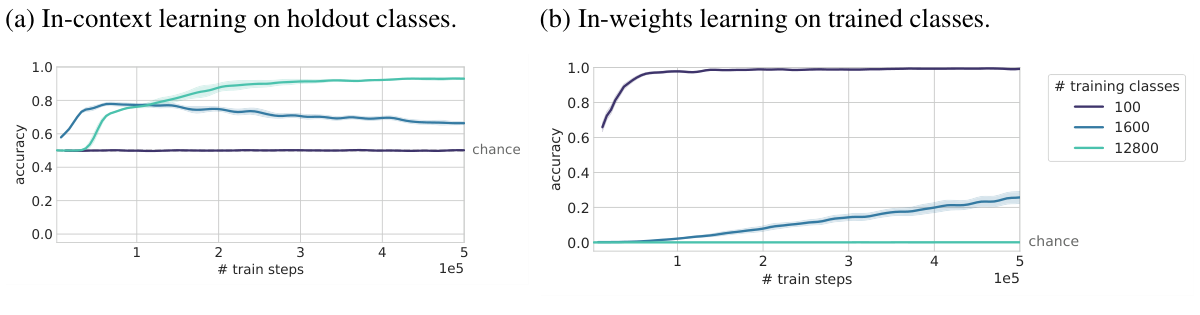
来源:图 3,PDF p. 4;Sec. 3.1,p. 5。颜色对应 100、1,600、12,800 个训练类别,其他读图方式与图 2 相同。
100 类条件主要表现为 IWL,ICL 接近随机。类别增多后,ICL 提高,IWL 降低。图 3 的训练末期,12,800 类条件的 ICL 约在 0.9 以上,而 IWL 接近随机;这是图上量级观察,不是原文表格报告的精确结果。
作者指出,即便考虑单个类别的曝光次数,1,600 类条件的 IWL 学得仍比 100 类慢,因此其解释不只是“每类见得少了”。不过文中没有给出可独立核算这一控制的完整数值表。
12,800 类来自训练图像的四种旋转与左右翻转,组成 $8\times$ 扩展;holdout 不包含训练图像的变换版本。**限制:**有些字符有旋转或镜像对称性,变换后图像相同但标签可能不同,因此该条件同时可能引入标签多重性,不能视为只改变类别数量的完全纯净干预。(p. 5)
4.3 标签在局部稳定、在全局可变时,ICL 更有用
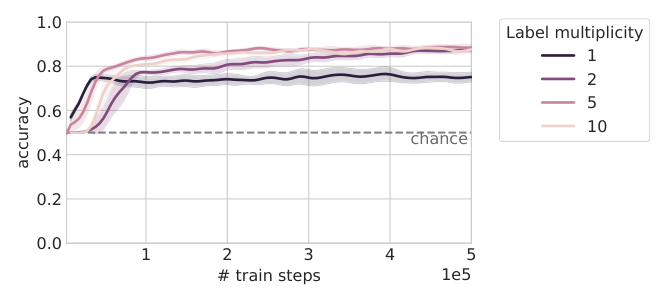
来源:图 4,PDF p. 6;Sec. 3.1,pp. 5–6。横轴为训练步数,纵轴为 holdout 类别的二选一 ICL 准确率;图例是每类候选标签数量。
每个图像类别分配多个可能的标签;跨序列可以选择不同标签,但同一序列中的该类别始终保持同一标签。随着 multiplicity 从 1 增加到 2、5、10,整体 ICL 曲线提高;高 multiplicity 条件之间差异小,不能据图声称严格逐档显著提升。
**教学解释:**当 A 在某次序列表示 7、另一次表示 12,单纯记忆 A→某个唯一标签不再稳定;读取当前上下文更可靠。它仍弱于每个 episode 完全重置所有类别标签的标准元训练,因为每类只在有限候选标签间变化。图 4 直接展示的是 ICL,不能据此补造同条件的 IWL 数值。
4.4 适度的类内变化也会促进 ICL,但不是“噪声越大越好”
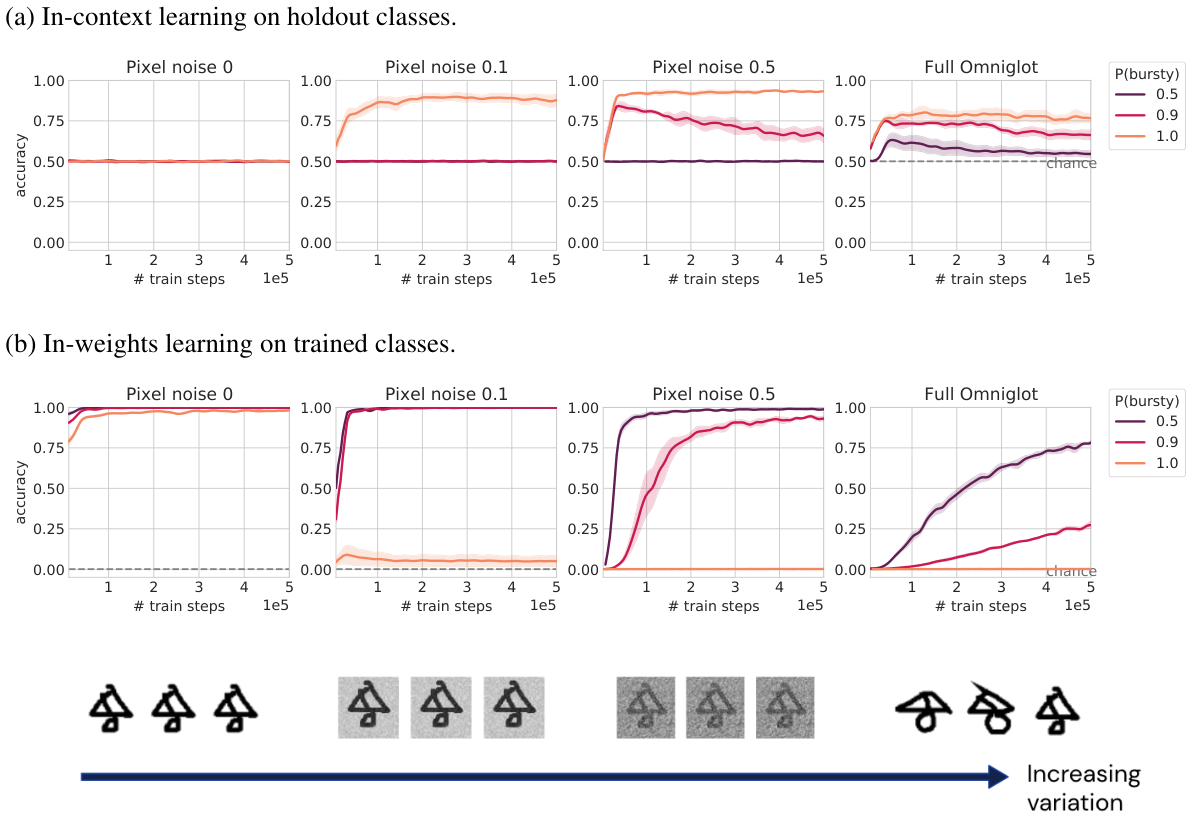
来源:图 5,PDF p. 6。四列依次为固定单图、像素噪声 0.1、像素噪声 0.5、完整 Omniglot;上排是 ICL,下排是 IWL,颜色是 burstiness。底部作者示意图说明变化类型。
当每类总是完全相同的一张图时,即使有 burstiness,模型也很容易走向参数记忆,ICL 保持随机水平。加入每次重新采样的像素噪声后,特别在高 burstiness 条件下,ICL 明显出现,而 IWL 受抑制。
作者把它解释为:类内变化使参数记忆比上下文策略受到更大影响。但完整 Omniglot 的 20 种书写差异又会增加视觉泛化难度,因此该条件的 ICL 并不总高于噪声条件。**结论是策略选择与识别难度存在竞争,不是无条件鼓励增强噪声。**图 5 有 3 个 seed,不能将均值曲线中所有小差异当成可靠排序。
4.5 Zipf 分布使常见类别的 IWL 与新类别的 ICL 共存
前几组实验的类别边际分布基本均匀。作者引入非均匀频率,试图让少数常见类别值得记忆,同时让大量罕见类别维持学习上下文策略的价值。
原文唯一编号公式为:
$X$ 是类别的频率排名,$x=1$ 为最常见类别,$\alpha\ge0$ 控制偏斜程度。它描述跨类别的边际频率,与描述序列内重复的 $p(\mathrm{bursty})$ 是两个不同维度。
为便于理解,本笔记补写有限 $N$ 类时的归一化形式:
$\alpha=0$ 就是均匀分布;增大 $\alpha$ 会将更多概率质量集中到头部。后一公式只是式 (1) 的展开,不是原文第二个编号公式。
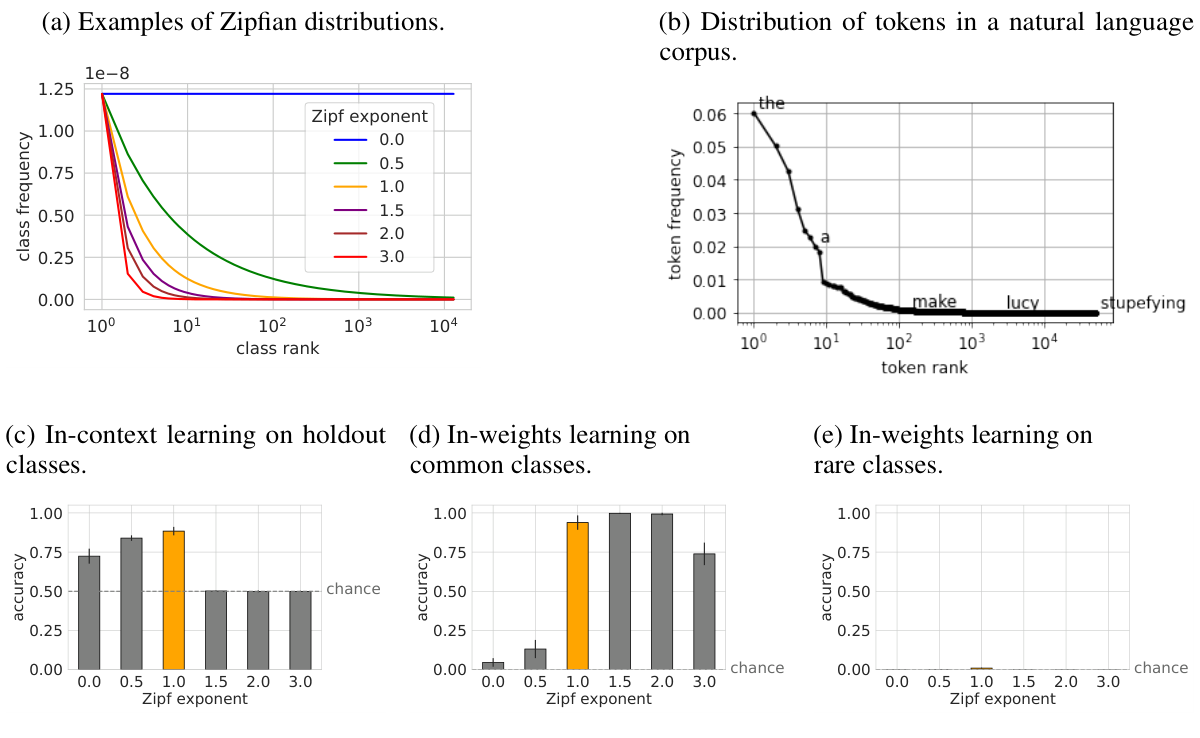
来源:图 6,PDF p. 7;Sec. 3.2,pp. 7–8。上排是分布示意和 Brown 语料词频;下排依次为新类别 ICL、前 10 个常见训练类别的 IWL、其余训练类别的 IWL。下排横轴是 $\alpha$,纵轴是准确率,柱高是 400k–500k 训练步窗口的平均评估准确率;共 3 个 seed,误差条为标准差。
| 条件 | 新类别的二选一 ICL | 常见类别 IWL | 其余类别 IWL |
|---|---|---|---|
| $\alpha=0$ | 明显高于 50% | 较低 | 接近随机 |
| $\alpha=1$ | 较高 | 较高 | 接近随机 |
| $\alpha\ge1.5$ | 图中接近 50% | 总体较高;$\alpha=3$ 回落 | 接近随机 |
这里刻意不从柱高制造小数点后的精确数字。图示中 $\alpha=1$ 的两个前述能力约处于 0.9 量级。作者将 $\alpha=3$ 的 IWL 回落解释为分布过于集中:最常见三个类别约占 97% 的数据,对“前十类”的整体学习反而不利。(p. 8 脚注 3)
有两个重要限定。第一,图 6(c) 在 $\alpha=0\to1$ 区间并非单调下降,明显崩落出现在更大的指数;图注关于“增加偏斜使 ICL 下降”的说法应理解为整体极端趋势。第二,$\alpha=1$ 的合适性只是当前 12,800 类、$p=0.9$ 等条件下的发现,不是通用最优指数。作者也明确说最优点可能随训练方案变化。
4.6 附录揭示:能区分上下文标签,不等于会在所有标签中选择它
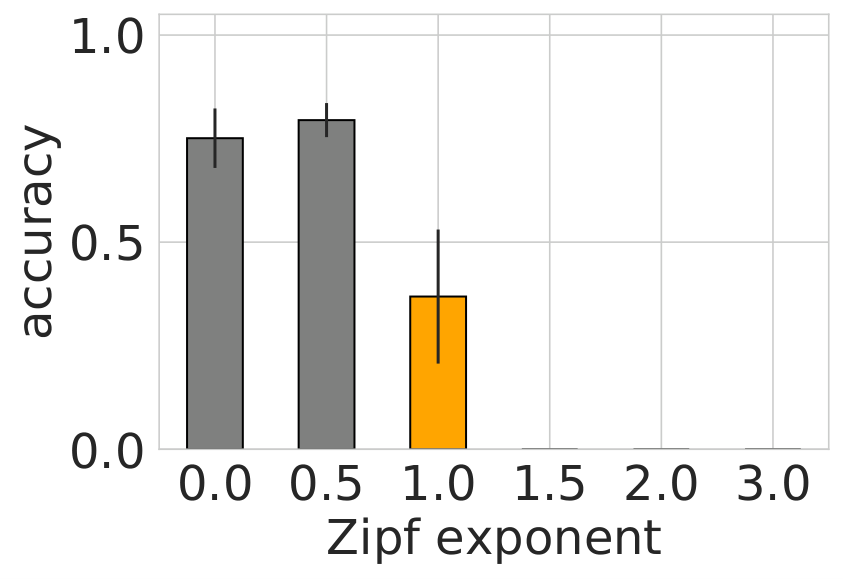
来源:图 10(e),PDF p. 18。该图与主文图 6(c) 使用同一类 ICL 序列,但按全部输出标签计分。
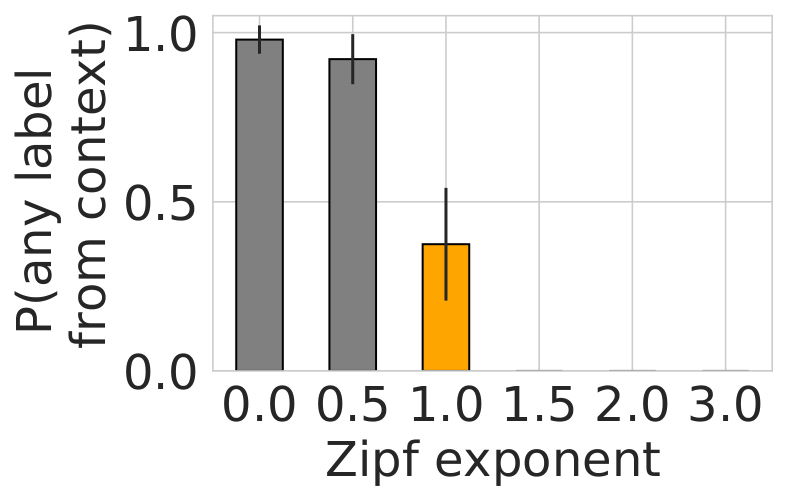
来源:图 11,PDF p. 18;附录 C.4,p. 16。纵轴表示最终输出是否属于上下文中的两个标签,不表示给这两个标签分配的总概率质量。
在 $\alpha=1$ 下,完整多分类准确率明显低于二选一分数,图示约为 0.35–0.4;输出任一上下文标签的频率也只有约 0.4。以上是估读量级,原文未提供精确表格。这意味着该模型经常选择上下文之外的标签,尽管把候选限制为 0、1 时能够较好地判断哪一个正确。
因此,论文的“共存”支持同一模型具备两种诊断能力,但不能直接推出它总能自动选择适合当前任务的信息来源。作者将其解释为模型可能同时处理两条路径,却对最终输出哪一条结果不确定;这仍是行为解释,没有内部电路或因果干预证据。
另两个附录检查也值得保留:
- **已训练类别重新赋标签(C.3、图 9,pp. 15–17):**趋势与 holdout 类别相似,整体略高。ICL 不局限于“从未见过图像”这一情形。
- **完整多分类整体趋势(C.4、图 10,pp. 16、18):**主要方向仍大体相似,但比较类别数和标签多重性时,输出标签数与随机基线会改变,不能把不同条件的原始准确率当成同等难度比较。
4.7 架构确实相关,但匹配程度与结论范围需要准确表述
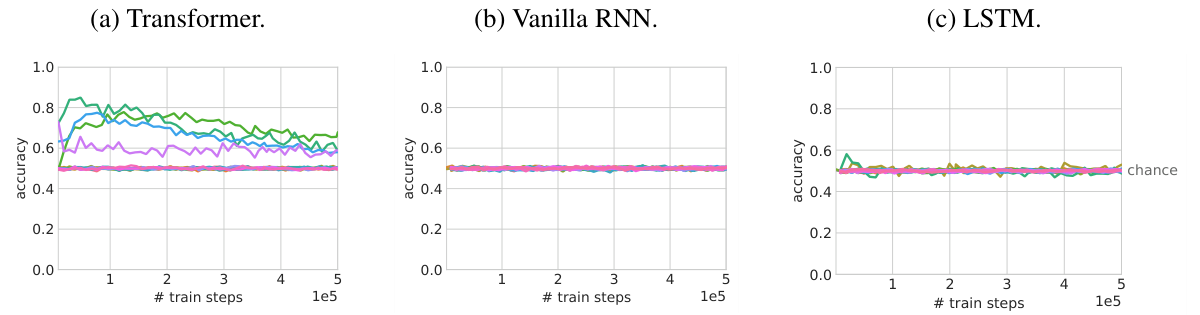
来源:图 7,PDF p. 8;Sec. 3.3,p. 8。三幅图分别为 Transformer、vanilla RNN、LSTM,横轴为训练步数,纵轴为二选一 ICL 准确率。每条彩线是一个超参数运行,颜色不代表可跨面板对应的同一超参数配置,也不是均值加误差条。
在作者搜索的设置中,Transformer 的部分运行明显超过 50%,RNN/LSTM 未能取得持续高于随机的 ICL。附录图 8 进一步显示 Transformer 的 IWL 也相近或更好,不能仅用“循环模型更偏好参数记忆”解释结果。
架构搜索涵盖 3 种架构、2 或 12 层,每个架构深度组合 15 次运行,共 90 次。最大学习率按对数均匀分布取自 $[10^{-5},0.1]$,warmup 步数取自 $[1,10000]$。这是 15 组配置,不是两个参数分别 15 个值组成 225 次网格。(附录 C.1,p. 15)
**原文内部的匹配表述有出入:**Sec. 3.3 与图 7/8 图注写到参数数量匹配,但附录给出的数目并不相等:
| 层数 | Transformer | LSTM |
|---|---|---|
| 12 | 831,479 | 627,959 |
| 2 | 331,639 | 297,719 |
来源:附录 C.1,p. 15;vanilla RNN 的参数量未在该列表中报告。更稳妥的结论是:**在所测数据、深度、隐藏维度和超参数搜索下,Transformer 表现出更强的 ICL;这不是严格等参数的普遍架构定理。**实验没有排除其他循环架构、记忆机制、训练预算或任务协议也能获得 ICL。
五:结论、局限与可继续追问的问题
5.1 这篇论文可靠地增加了哪些认识?
- **训练数据结构会影响学到的策略。**局部可用的信息、全局记忆的难度及关联的稳定性,都可能改变 ICL/IWL 的相对表现。架构固定并不意味着能力偏好固定。
- **全局稀有与局部重复可以同时存在。**这一点解释了长尾数据为何不一定只带来学习困难:罕见类别在一个上下文里反复出现,可以为临时关联提供训练信号。
- **能力共存依赖频率分工,也受评估方式约束。**Zipf 设置提供了常见类别可记忆、其他类别可上下文学习的行为证据;完整输出空间的结果要求我们继续研究模型如何决定采用哪种信息。
前两项是对受控结果的概括;“频率分工”的内部实现是作者解释和本次理解,论文未直接定位实现该分工的注意力头、层或参数子空间。
5.2 阅读时必须保留的边界
- **任务外推:**Omniglot 图像分类、17-token 序列、查询交叉熵,不等同于自然文本的长序列 next-token 训练。语言、强化学习与认知的启示属于待验证方向。
- **指标边界:**ICL 主结果是限制候选的二选一准确率;不能当作全标签空间性能,更不能当作生成新标签的能力。
- **干预混杂:**12,800 类的变换扩展可能同时产生标签歧义;增加类内变化也同时改变识别难度。
- **统计边界:**一般实验 3 或 5 个重复、误差条为标准差;没有为所有比较提供检验方法或显著性数值,因此不把曲线的每处差异写成统计显著。
- **架构边界:**附录参数数目与正文的匹配措辞不一致;阴性结果仅涵盖被测试的 RNN/LSTM 设置。
- **时间边界:**结果观察到 500k 步,部分 ICL 随训练减弱;不能据此推断无限训练后的稳定能力或最优停止点。
5.3 三个适合组会讨论的后续实验
以下是本次分析提出的建议,不是论文已完成的实验。
- 固定输出标签空间、类别曝光次数和真正不同的视觉类别,独立改变局部重复与频率尾部,减少类别扩展的混杂。
- 对 Zipf 模型同时报告二选一准确率、完整多分类准确率和“输出属于上下文标签”的频率,并把 0/1 标签替换为不同频率的熟悉标签,分离标签先验影响。
- 在更严格匹配参数量与计算预算的模型中,追踪 ICL 向 IWL 变化的训练过程,再用内部表示分析或干预检验是否存在可识别的策略切换机制。
阅读与材料核验说明
本笔记以同版本作者主 TeX 为正文与公式依据,以 PDF 核对最终页码、图例和附录。原图均从作者资产复制或从 PDF 精确裁切,没有生成或重绘实验曲线。正文中的数学教学表达、举例和后续实验建议均与原文结果区分;参考文献列表没有逐篇拓展阅读。
作者公开代码入口:emergent_in_context_learning。此处仅记录论文给出的链接,不声称已审计代码或复现实验。重编译幻灯片可在本目录运行 python3 build_slides.py slides.en.tex;图件应与 TeX 一并保留。