SRWM:让权重矩阵学习修改自身
论文:A Modern Self-Referential Weight Matrix That Learns to Modify Itself
作者:Kazuki Irie、Imanol Schlag、Róbert Csordás、Jürgen Schmidhuber
发表与版本:ICML 2022;arXiv:2202.05780 v2,2022-06-17 修订
获取与研读日期:2026-10-16
原文:arXiv v2 · 本地 PDF · 英文汇报幻灯片 · 作者代码
论文总览
这篇论文研究一个具体问题:神经网络能否把“怎样根据新经验调整自己”也写进会随经验变化的权重中?作者提出自指权重矩阵(Self-Referential Weight Matrix,SRWM):同一个矩阵既处理输入、给出输出,也产生读取地址、写入地址和学习率,再利用这些量修改自身。变化不仅发生在预测部分,也发生在生成下一次修改指令的部分。
SRWM 从快速权重编程器(Fast Weight Programmer,FWP)发展而来。DeltaNet 用固定的慢权重网络生成更新指令,修改另一块快权重;SRWM 将这两个角色合并。外部训练通过梯度下降优化初始矩阵 $W_0$,实际处理一个任务时则执行学到的自修改递推。实验展示了这种结构的可训练性和实际用途:标准少样本分类与 DeltaNet 接近,顺序多任务分类有改善,ProcGen 多任务强化学习也获得较好的测试得分。
最值得记住的是可改变的参数化更新控制器。论文并未直接测量持续递归自我改进:作者在 Sec. 6 明确把专门测量自我改进的任务留给后续工作。这里的证据主要来自预测与控制任务中的运行时适应。(Sec. 3–6,PDF pp. 2–9)
结构地图
下列页码均为从 1 开始的 PDF 页码。
| 原文章节 | 在论证中的作用 | PDF 页码与关键证据 |
|---|---|---|
| 1. Introduction | 从固定程序引出运行时自修改 | pp. 1–2 |
| 2. Background on Fast Weight Programmers | 建立 DeltaNet 的慢网/快网基线 | p. 2;式 (1)–(4) |
| 3. A Modern Self-Referential Weight Matrix | 定义 SRWM 的闭环更新 | pp. 2–3;图 1,式 (5)–(8) |
| 4.1. Standard Few-Shot Learning | 检验自修改是否能支持任务内学习 | pp. 3–4;图 2–3,表 1 |
| 4.2. Sequential Multi-Task Adaptation | 检验输入分布突变后的连续适应 | p. 5;表 2,图 4 在 p. 6 |
| 4.3. Multi-Task Reinforcement Learning (RL) | 检验多游戏联合训练、专家对照与重置消融 | pp. 5–7;图 5,表 3–4 |
| 5. Discussion | 状态容量、解释性、计算代价与应用限制 | pp. 7–8 |
| 6. Related Work | 与早期 SRWM、可塑性、层次 FWP 和元 RNN 对照 | pp. 8–9 |
| 7. Conclusion | 总结结构与三组实证结果 | p. 9 |
| A. SRWM Model Details | 四学习率、多头与参数量差异 | p. 13;式 (9)–(11) |
| B. Experimental Details for Few-Shot Learning | 数据、训练、评估、FC100、LSTM、反向切换及训练失败 | pp. 13–16;表 5–7,图 6–9 |
| C. Additional Results for Reinforcement Learning Experiments | SR-DeltaNet 的部分可观测环境实验与逐游戏得分 | pp. 16–18;表 8–10 |
一:动机——让生成更新指令的部分也能适应
普通网络通常在训练后固定参数。即使一个固定权重 RNN 能通过隐藏状态改变行为,其状态转移规则的参数仍保持固定。FWP 更进一步:慢网络根据输入生成快网络的权重更新,快网络的计算程序因此随上下文变化。然而,标准 FWP 中负责生成更新的慢网络仍然固定。
可以继续增加层次:再用一个网络生成慢网络的权重。但只要层次有限,最高层仍然固定。SRWM 的处理方式是把生成指令和执行指令的矩阵合并,使这个矩阵连生成 key、query 和学习率的部分也能更新。这里仍有固定的结构规则,例如矩阵乘法、softmax、sigmoid 和 delta 更新的形式;学到并随时间改变的是这些规则中的控制量及其生成参数。(Sec. 2、3、6,PDF pp. 2–3、8)
作者也并非首次提出神经网络自修改。早期 SRWM 通过显式权重索引读写单个参数;本文用向量地址和外积,一次产生整块矩阵上的秩一修改。它将自指机制落实到现代快速权重与线性 Transformer 常用的计算形式中。(Sec. 6,PDF p. 8)
与神经调制可塑性(neuromodulated plasticity)相比,关键区别是读写模式的来源:一些可塑性方法把 key、query、value 固定对应到当前层的输入或输出,而 SRWM 通过学到的变换生成这些向量,且变换自身也能改变。与语言模型的动态评估(dynamic evaluation)相比,后者通常用固定的梯度下降算法在测试时更新权重,SRWM 则允许生成更新的参数化控制器也参与适应。(Sec. 6,PDF p. 8)
二:方法——一次前向计算如何成为一次自修改
2.1 先理解 DeltaNet 的两个角色
对输入 $x_t\in\mathbb R^{d_{\mathrm{in}}}$,DeltaNet 先用慢矩阵生成 key、value、query 与学习率 logit:
然后读取 key 处的旧内容,写入误差修正,最后查询更新后的快矩阵:
这里 $W_t\in\mathbb R^{d_{\mathrm{out}}\times d_{\mathrm{key}}}$,而 $W_{\mathrm{slow}}\in\mathbb R^{(d_{\mathrm{out}}+2d_{\mathrm{key}}+1)\times d_{\mathrm{in}}}$。$\phi$ 将地址变成正值、和为 1 的向量,文中采用 softmax;$\sigma$ 是 sigmoid。$\beta_t$ 本身是未归一化的实数,真正乘在更新上的门值是 $\sigma(\beta_t)$。
外积 $(v_t-\bar v_t)\phi(k_t)^\top$ 的意义是:以 key 为写入地址,将该地址当前读出的值向目标值修正。相比只不断累加 $v_t\phi(k_t)^\top$,delta 规则还考虑“这里已经存了什么”。$W_{\mathrm{slow}}$ 通过训练学习生成这些指令;快矩阵通常从零开始,随当前输入流更新。(Sec. 2,PDF p. 2,式 (1)–(4))
2.2 SRWM:同一矩阵生成并接收更新
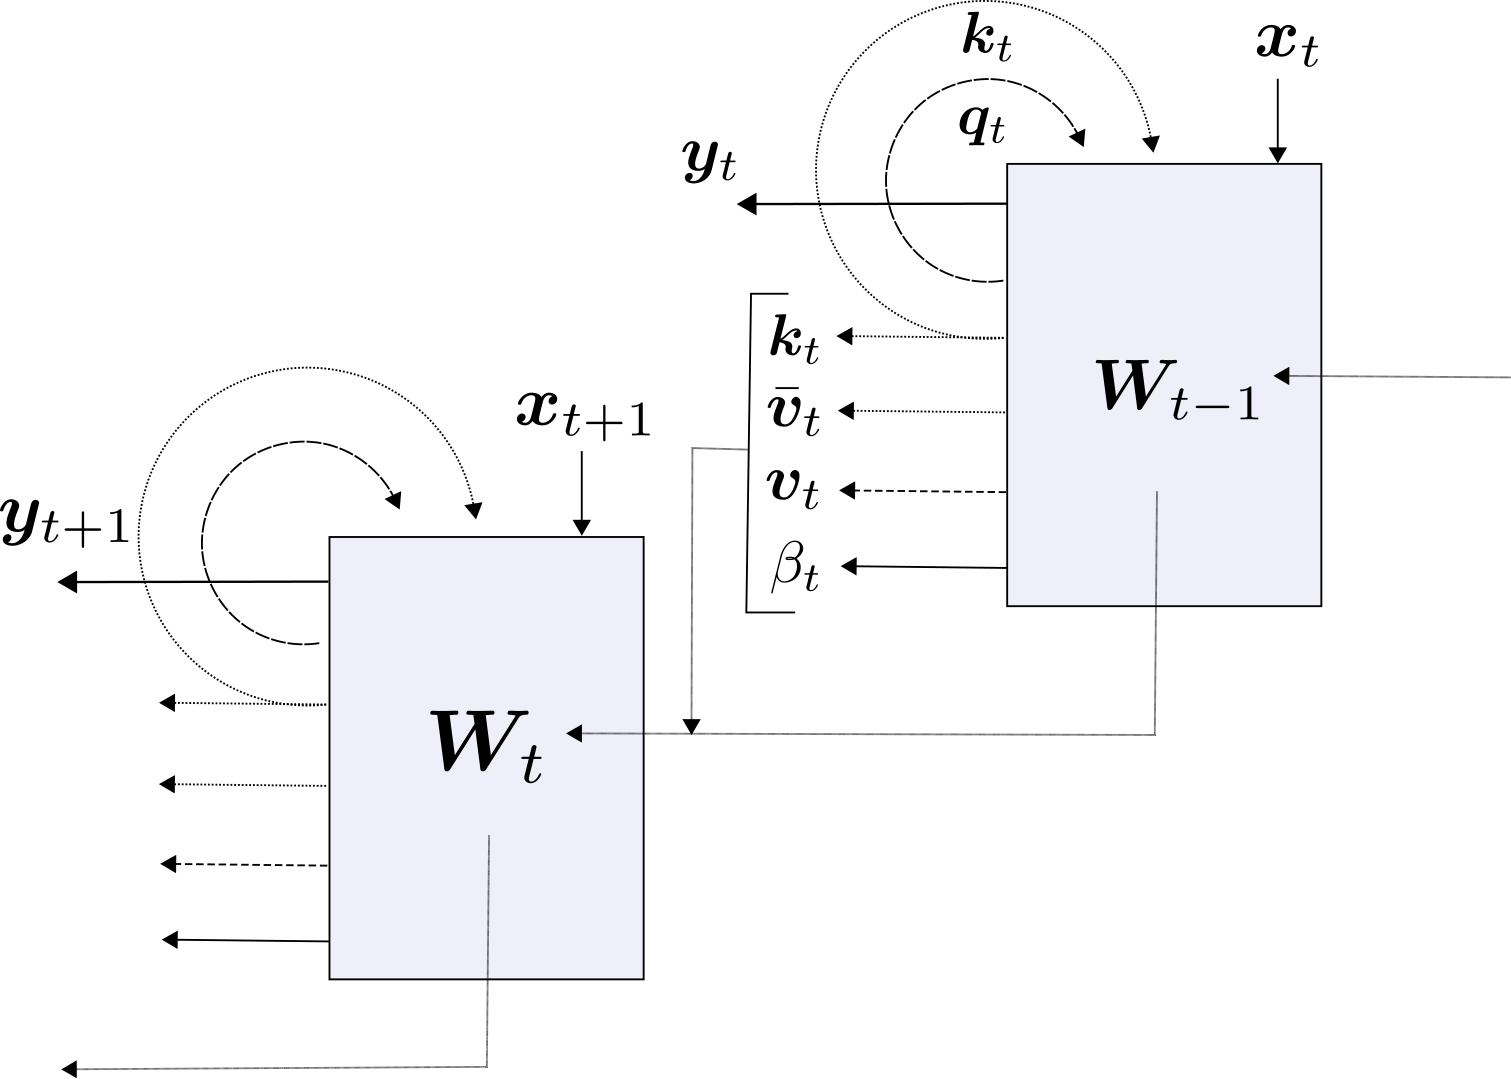
原图 1,PDF p. 2。图中 $W_{t-1}$ 既响应当前输入 $x_t$,又响应自身产生的 $k_t$ 和 $q_t$;这些读取结果构成 $W_t$ 的更新。图是按时间展开的同一个动态矩阵。
先看只有一个学习率的版本。令 $m=d_{\mathrm{out}}+2d_{\mathrm{in}}+1$,则:
| 符号 | 形状 | 作用 |
|---|---|---|
| $x_t$ | $d_{\mathrm{in}}$ | 当前层输入,可能已融合图像特征与标签反馈 |
| $W_{t-1}$ | $m\times d_{\mathrm{in}}$ | 预测与生成修改指令共用的当前矩阵 |
| $y_t$ | $d_{\mathrm{out}}$ | 当前层输出 |
| $k_t,q_t$ | 各 $d_{\mathrm{in}}$ | 待修改地址与目标内容的读取地址 |
| $\beta_t$ | 标量 | 修改幅度的 logit |
| $\bar v_t,v_t$ | 各 $m$ | 旧内容与目标内容;覆盖矩阵的所有输出块 |
论文的四步递推为:
第一步决定这次要做什么。 当前矩阵直接产生输出 $y_t$,同时生成 $k_t,q_t,\beta_t$。$k_t$ 是需要修改的位置,作者称为 modifier-key;$q_t$ 是提供目标内容的位置,称为 analyser-query。
第二、三步读取两份完整内容。 $\bar v_t$ 是 $k_t$ 地址处现有的内容,$v_t$ 是从 $q_t$ 地址取出的目标。两者都包含预测、key、query、学习率等行块的输出。因此,这里的 value 不等同于分类标签,维度也不只是 $d_{\mathrm{out}}$。
第四步把变化写回整个矩阵。 更新会触及生成下一次 key、query 和学习率的行块。这正是自指机制的关键:当前的修改可以改变未来生成修改指令的方式。(Sec. 3,PDF p. 3,式 (5)–(8))
注意时序:SRWM 的 $y_t$ 由更新前的 $W_{t-1}$ 产生;DeltaNet 的式 (4) 则查询更新后的 $W_t$。两种计算不能只替换矩阵名称而忽略先后顺序。
2.3 delta 更新的直觉与一个小推导
以下是根据式 (8) 给出的教学推导。暂记 $k=\phi(k_t)$、$q=\phi(q_t)$、$\eta=\sigma(\beta_t)$、$W=W_{t-1}$,并把本步生成的量视为固定,则
在更新后重新读取同一地址 $k$:
所以原地址的读出会向目标读出靠拢。由于归一化地址满足 $1/d_{\mathrm{in}}\leq\lVert k\rVert_2^2\leq1$,有效插值幅度还取决于 key 的集中程度。只看学习率门值,无法判断一次更新究竟有多强。
对其他地址 $z$,有
这说明写入具有关联式影响:与 key 重叠越大的地址,读出受到的改变越大。它也解释了为什么多次写入之间可能产生干扰。
一个极简例子:只看预测子块的一行 $w=[1,3]$,令 key 和 query 接近 one-hot 地址 $e_1,e_2$,且 $\eta=0.5$。那么旧值是 1、目标是 3,更新得到 $w'=[2,3]$。这是给定地址后的单次更新示意;真实模型还必须自己产生这些地址,并对其余行块执行同样的运算。
2.4 实际使用四个学习率与多个计算头
实现将矩阵按输出分成 $W^y,W^k,W^q,W^\beta$ 四个行块,并让 $\beta_t\in\mathbb R^4$。总输出维度因此变为 $d_{\mathrm{out}}+2d_{\mathrm{in}}+4$。例如预测子块的更新是:
其余三块分别使用自己的门值。即使是生成学习率的 $W^\beta$,也在自修改的对象之内。(Appendix A,PDF p. 13,式 (9)–(11))
多头版本先把输入拆成 $H$ 份,每头独立执行 SRWM。若每头宽度为 $d$,总宽度为 $D=Hd$,key 生成矩阵的形状是 $(H,d,d)$;对照 DeltaNet 的全维度慢投影是 $(D,D)$。因此,同样的隐藏宽度和头数并不意味着两者参数量相同。
架构仍保留 Transformer 式前馈块、残差连接和层归一化,图像任务还使用视觉编码器。这些外围模块并没有全部变成自修改矩阵。以每头输入、输出宽度均为 $d$ 为例,SRWM 动态状态有 $H(3d+4)d$ 个标量;每步矩阵向量乘法和外积的主成本为 $O(Hd^2)$,固定宽度下处理长度 $T$ 的序列为 $O(THd^2)$。这是由公式得到的计算量分析;它不代表递推时间步可以像普通全序列注意力一样直接并行。(Sec. 2、5;Appendix A,PDF pp. 2、7、13)
还有一个容易漏掉的实现条件:监督实验在式 (5) 中不对 $x_t$ 施加激活函数;RL 实验才对它使用 softmax。 key/query 读取和写入处仍使用归一化的 $\phi$。不能把正文简式中的三个 $\phi$ 无差别地套到所有实验。(Appendix B.2,PDF p. 14)
2.5 训练学习初始程序,运行时执行这个程序
SRWM 层中通过梯度下降训练的是初始矩阵 $W_0$。训练时把若干步自修改展开,对任务损失反向传播,学习“从怎样的初始矩阵出发,能在接收经验后变成有用的矩阵”。其他视觉和前馈模块照常参与外部训练。
任务内适应则直接执行式 (5)–(8),不需要为每个支持样本运行一次任务损失的梯度下降。少样本学习中的标签作为输入信息影响后续更新;RL 中不同轨迹生成不同的有效权重。可以把外部训练目标概括为优化 $W_0$ 及外围参数,使整个动态计算过程的任务表现良好,而非优化一个固定推理函数。
这也解释了它与 MAML 的差异:两者都学习有利于适应的起点,但 MAML 使用梯度下降执行任务内适应,SRWM 的任务内更新由自身产生的地址、目标和门值驱动。还有一个直接推论:若 SRWM 整块 $W_0=0$,则两次读取都为零,更新也为零,矩阵会停在零点。因此,不能照搬 DeltaNet 把快权重置零的初始化方式来初始化完整 SRWM。(Sec. 3、4.1,PDF pp. 3–4;最后一项为根据式 (5)–(8) 的推论)
三:实验——三类任务分别检验什么
3.1 标准少样本分类:能否学会利用支持集
每个 $N$-way $K$-shot episode 随机选择 $N$ 个类别,并重新随机分配标签。$NK$ 个带标签样本组成支持集,另取未出现在支持集中的 query 图像。重新编号使网络必须从当前 episode 学习类别与标签的对应关系。
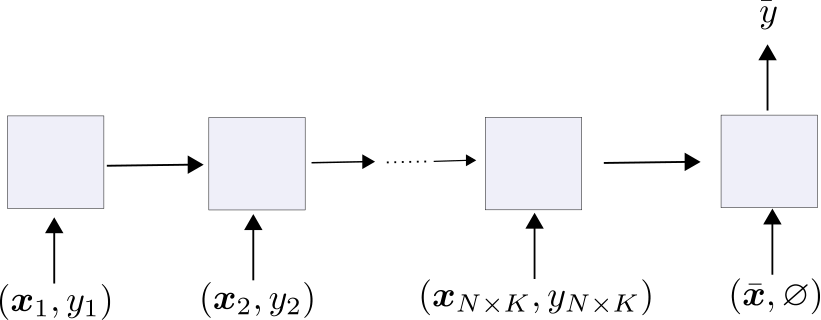
原图 2,PDF p. 3。按从左到右阅读:前 $NK$ 步同时输入图像和正确标签,最后输入没有标签的 query,仅在最后一步预测。SRWM 在读取支持集时更新自身,然后用所得权重分类 query。
实验包括 Omniglot、Mini-ImageNet,附录增加 FC100。Mini-ImageNet 的类别按 64/16/20 划分训练、验证、测试,输入为 $84\times84$;FC100 按 60/20/20 划分,输入为 $32\times32$。Omniglot 单任务输入为 $28\times28$,使用旋转扩增;其类别划分原文记为 1028/172/432。(Appendix B.1,PDF p. 13)
最直接的对照是 DeltaNet:两者都是通用序列模型,差别在于更新指令是否也由动态参数生成。SNAIL 也是通用序列模型;MAML 是梯度式元学习对照;fwCNN-Hebb 和 HyperTransformer 则采用专为少样本分类设计的权重生成机制。fwCNN-Hebb 将图像和标签分别用于生成 key 和 value;HyperTransformer 用 Transformer 编码支持集、生成卷积网络权重。这些差异决定了不能只按一列准确率解释方法优劣。(Sec. 4.1,PDF p. 4)
主表 Mini-ImageNet 比较通常使用 Conv-4-32,fwCNN-Hebb 使用更大的 Conv-5-64。另有一处影响复现的原文差异:Sec. 4.1(p. 4)称 Omniglot 使用 64 通道,而 Appendix B.2(p. 13)概括 Conv-4 使用 32 通道;因此本文不把 Omniglot 的通道数写成无歧义配置。
作者自己的少样本结果按 5 组、每组 16K 个测试 episodes 计算均值和 95% 置信区间。这里衡量的是抽取测试任务的波动;原文明确指出它没有刻画不同训练随机种子的方差。(Appendix B.3,PDF p. 14)
3.2 顺序多任务:切换数据分布后能否继续学习
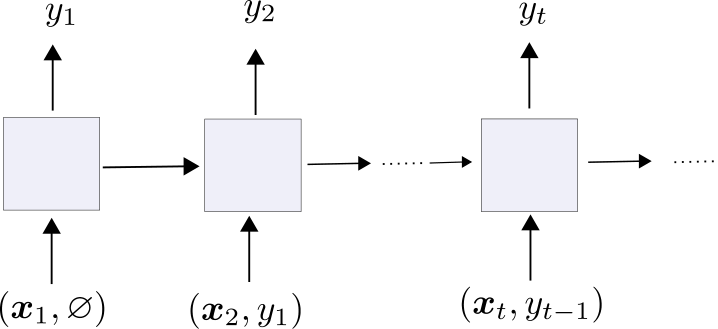
原图 3,PDF p. 3。每一步输入当前图像及前一步的正确标签,并对当前图像作预测。它提供连续的预测—反馈流,因此比只在 episode 末尾预测一次更适合测试运行中的任务切换。
每段都是 5-way 分类,每类最多 15 个样本;将 Omniglot 和 Mini-ImageNet 两段拼接。训练时每个 batch 交替拼接顺序,并从各段随机裁掉 1–60 个位置,使段长和各类出现次数变化。为了共用视觉编码器,Omniglot 图像扩展到 $84\times84$ 和三个通道。两个模型都使用 3 层、隐藏宽度 256、16 个头、前馈内层宽度 256;batch size 为 32,学习率为 $3\times10^{-4}$。(Sec. 4.2;Appendix B.1、B.5,PDF pp. 5、13、16)
测试关注两类指标:整段总体准确率,以及每类第 $k$ 次出现时的 instance-level 准确率。后者更直接显示模型在收到反馈后学得怎样。这里测试的是运行时分布切换后的适应;协议没有返回先前任务来测量旧知识保持。
3.3 多任务 RL:共享起点能否适应不同游戏
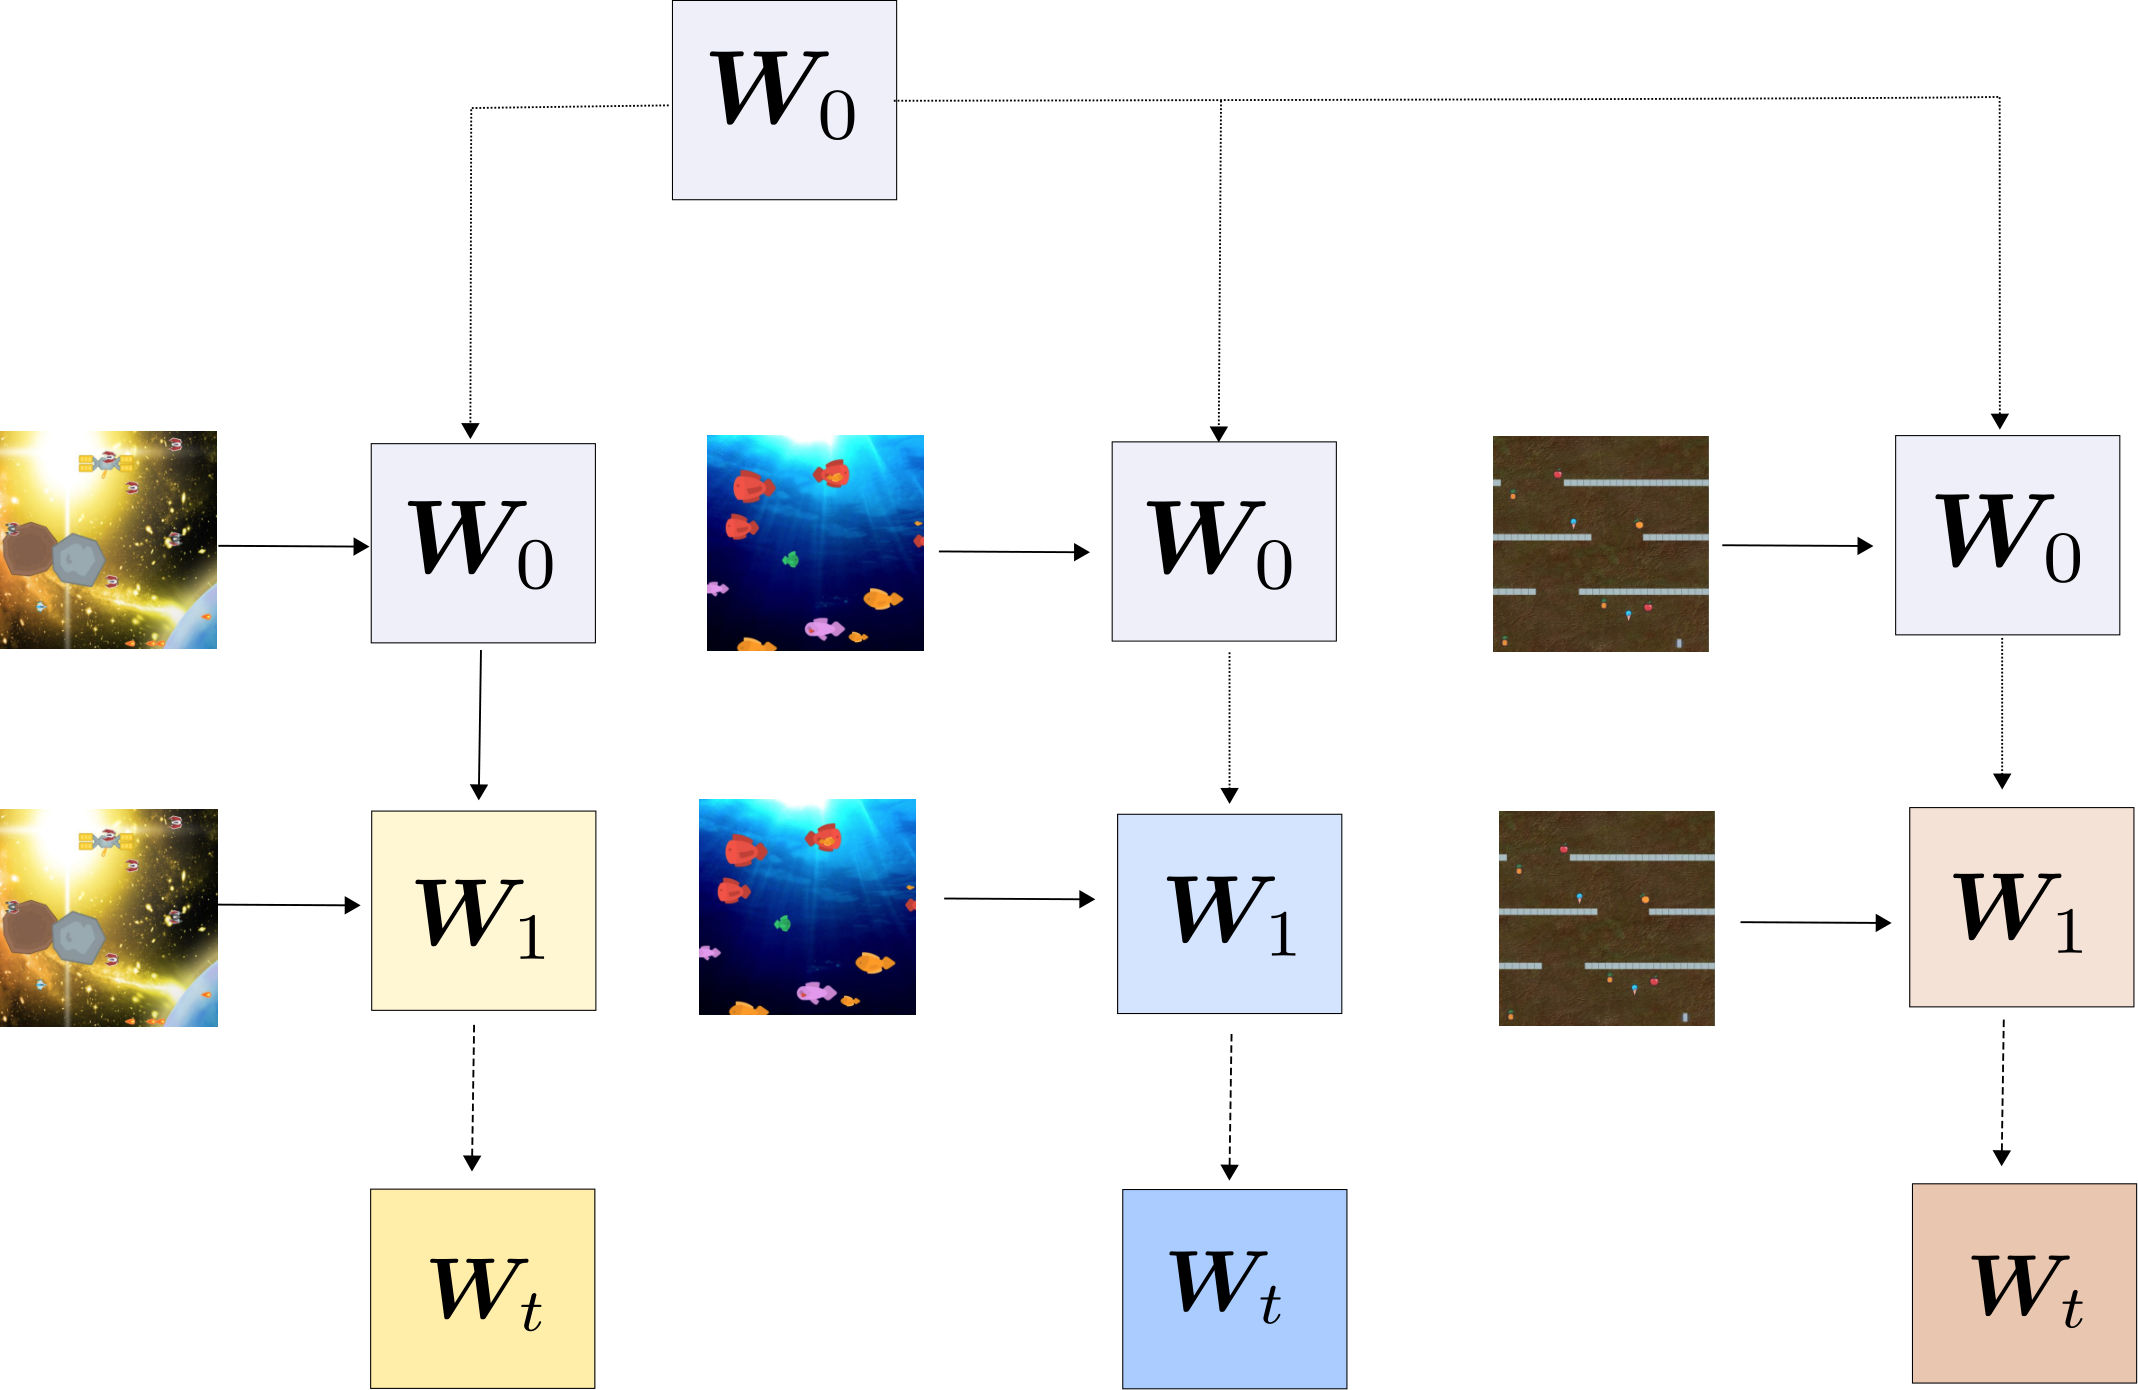
原图 5,PDF p. 6。各游戏和各 episode 共用初始矩阵 $W_0$,随后随各自的观测流得到不同的 $W_t$。
主实验联合训练 ProcGen easy 分布中的 Bigfish、Fruitbot、Maze、Leaper、Plunder、Starpilot,总计 300M 环境步,约每游戏 50M。使用 IMPALA/Torchbeast、48 个 actors、共享的 15 层残差卷积视觉模型。改变的是视觉模型与输出层之间的模块:FF、LSTM、DeltaNet、SRWM,以及去除自修改的 Fake SR。DeltaNet 与 SRWM 都为 2 层、隐藏宽度 128,LSTM 为 1 层、256 个单元。(Sec. 4.3,PDF pp. 5–6)
这 6 个环境并不显式要求长期记忆,作者希望借此观察自修改带来的任务适应收益。训练的反向传播跨度是 50 步,但状态一直保留到 episode 结束;截断梯度与重置状态是两件不同的事。
训练关卡为每游戏 ID 0–199;测试使用三个固定关卡集,分别为 1000–1199、1200–1399、1400–1599。每模型训练 3 次,训练分数统计 3 次运行,测试分数统计 3 次运行与 3 个关卡集组成的 9 个数据点。各游戏按 ProcGen 的常数归一化后聚合,再乘以 100;数值是归一化得分,不能当作分类准确率。(Sec. 4.3,PDF pp. 6–7,表 3)
四:结果——优势主要体现在哪里
4.1 单任务少样本:可用,与 DeltaNet 接近
以下为表 1 的原文结果,单位为准确率 %,越高越好。带星号的方法数据由原论文引用。
| 方法 | Omniglot 1-shot | Mini-ImageNet 1-shot | Mini-ImageNet 5-shot |
|---|---|---|---|
| MAML* | 98.7 ± 0.4 | 48.7 ± 1.8 | 63.1 ± 0.9 |
| fwCNN-Hebb* | 99.4 ± 0.1 | 50.2 ± 0.4 | 64.8 ± 0.5 |
| HyperTransformer* | 96.2 | 53.8 | 67.1 |
| SNAIL* | 99.1 ± 0.2 | 45.1 | 55.2 |
| DeltaNet | 97.2 ± 0.0 | 47.0 ± 0.1 | 62.7 ± 0.1 |
| SRWM | 97.4 ± 0.0 | 47.0 ± 0.2 | 61.4 ± 0.1 |
来源:Sec. 4.1,PDF p. 4,表 1;±0.0 是原表的显示精度。
SRWM 相对 DeltaNet 在 Omniglot 高 0.2 个百分点,Mini-ImageNet 1-shot 持平,5-shot 低 1.3 个百分点。相对 SNAIL,它在 Mini-ImageNet 高 1.9 和 6.2 个百分点,在 Omniglot 则更低。HyperTransformer 在 Mini-ImageNet 两项中最高。合理的结论是:将慢/快网络合并成自修改矩阵之后,仍能获得有竞争力的通用序列学习表现。
参数和训练预算也影响比较。Appendix B.2 报告 Mini-ImageNet 中 SRWM 约 3.6M 参数、DeltaNet 约 5.5M;两者分别调参,最佳层数分别为 3 与 4。二者训练 600K 步、batch size 16。这组结果并非严格等参数量消融。(PDF p. 14)
附录还提供了训练成功的 LSTM:Omniglot 1-shot 为 96.3±0.1;Mini-ImageNet 1-shot、5-shot 在 1.2M 步时分别为 46.6±0.1、59.0±0.1。其 Mini-ImageNet 模型有 7.5M 参数,且存在训练停在随机水平的配置,600K 步时两项分别低于 38% 和 55%。因此,固定权重 RNN 也可以学会任务内学习,但这里需要更大的模型和更长训练。(Appendix B.4,PDF pp. 14–15,表 6)
4.2 顺序任务:收益集中在较难的 Mini-ImageNet 部分
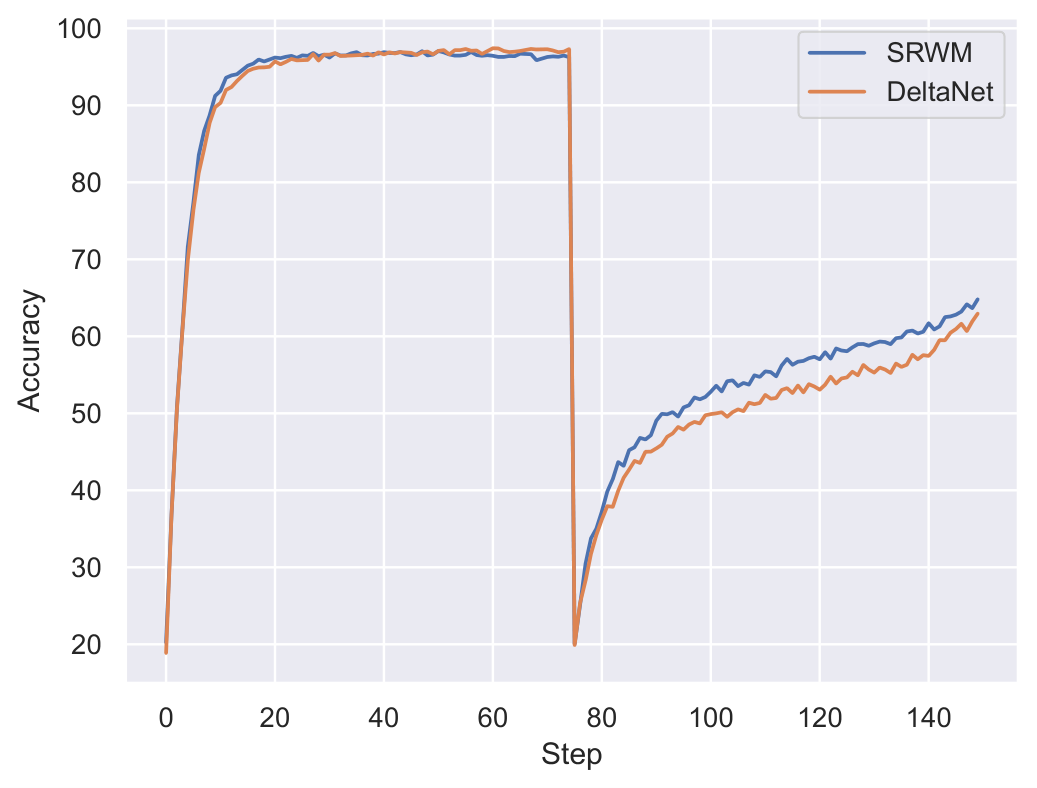
原图 6,PDF p. 15;正文图 4(p. 6)只展示 SRWM。横轴是输入位置,纵轴是跨测试任务平均准确率;蓝线为 SRWM,橙线为 DeltaNet。先学习 Omniglot,约在原文标记的 step 74 切换到 Mini-ImageNet,准确率降至随机水平附近,然后随新反馈回升。后半段 SRWM 的曲线整体更高。
表 2 中 Omniglot → Mini-ImageNet 顺序的精确结果如下:
| 当前段/模型 | 第 1 次 | 第 2 次 | 第 3 次 | 第 5 次 | 第 10 次 | 总体 |
|---|---|---|---|---|---|---|
| Omniglot / DeltaNet | 39.1 | 91.2 | 93.9 | 95.8 | 96.8 | 92.2 |
| Omniglot / SRWM | 40.6 | 92.1 | 94.8 | 96.3 | 96.7 | 92.3 |
| Mini-ImageNet / DeltaNet | 20.8 | 43.5 | 48.2 | 51.3 | 54.8 | 50.4 |
| Mini-ImageNet / SRWM | 20.9 | 46.0 | 50.3 | 54.2 | 58.0 | 53.3 |
单位为准确率 %。来源:Sec. 4.2,PDF p. 5,表 2。
Mini-ImageNet 总体提升 2.9 个百分点,每类第 10 次出现时提升 3.2 个百分点;第一次出现几乎持平。因此,收益主要体现为收到反馈后的学习表现。Omniglot 第一次出现时高于 20%,并不表示能凭空知道随机标签:作者指出,网络可能依据当前序列里哪些标签尚未用过,改进首次出现类别的猜测。
反向顺序的结果也有改善:
| 顺序:Mini-ImageNet → Omniglot | DeltaNet 总体 | SRWM 总体 | 差值(百分点) |
|---|---|---|---|
| 第一段 Mini-ImageNet | 50.7 | 53.5 | +2.8 |
| 第二段 Omniglot | 92.2 | 92.9 | +0.7 |
来源:Appendix B.4,PDF p. 16,表 7;曲线见 p. 15 图 7。Mini-ImageNet 不论在前还是在后都有收益,这使“只因为出现在第二段才获益”的解释不充分。
训练困难同样是实质结果。图 8 的失败模型主要改善第一次出现的分类,后续出现没有体现正常的反馈学习;图 9 的成功模型则在训练中转入“后续出现明显更准确”的行为。作者发现足够大的 batch size 很关键,最终用 32;随机种子与配置仍会影响能否学成。这里学的是一种更新行为,优化过程不一定自动找到它。(Appendix B.5,PDF p. 16,图 8–9)
4.3 多任务 RL:自修改有用,对 DeltaNet 的优势较温和
| 模型 | 可训练参数 | 训练归一化得分 | 测试归一化得分 |
|---|---|---|---|
| FF | 626K | 22.5 (2.6) | 16.4 (1.6) |
| LSTM | 1.2M | 28.3 (1.4) | 15.7 (1.6) |
| Fake SR | 959K | 27.0 (1.8) | 15.3 (1.9) |
| DeltaNet | 1.05M | 35.0 (1.6) | 18.6 (1.7) |
| SRWM | 968K | 34.6 (1.8) | 20.0 (1.8) |
来源:Sec. 4.3,PDF p. 7,表 3。括号为标准差;得分已乘 100,越高越好。
SRWM 相对 Fake SR 的测试均值高 4.7 个归一化分数点,相对 DeltaNet 高 1.4 点。前者是检验自修改机制作用的直接消融,且两者参数量接近;后者表明自指结构的测试均值略好。原表给出的标准差与均值差需要一起看,论文没有据此报告显著性检验。
平均值也遮住了游戏差异。下面摘取表 9 的逐游戏测试原始回报:
| 游戏 | FF | DeltaNet | SRWM |
|---|---|---|---|
| Bigfish | 4.3 | 7.8 | 9.0 |
| Fruitbot | 25.6 | 24.5 | 25.5 |
| Leaper | 3.4 | 3.3 | 3.4 |
| Maze | 1.4 | 1.7 | 1.8 |
| Plunder | 3.2 | 3.3 | 3.0 |
| Starpilot | 53.0 | 53.9 | 54.6 |
来源:Appendix C.2,PDF p. 17,表 9。此表为便于比较只摘取均值;各游戏原始分数的尺度不同。SRWM 并非每个游戏都最好,优势在 Bigfish 等环境更明显。
原文表 9 的 Aggregated / Train 行把 SRWM True、Fake 两列写为 27.0、34.6,与正文表 3 的 34.6、27.0 相反;测试聚合行一致。上面的训练汇总采用正文表 3,并保留这一原文差异,避免误读为关闭自修改后训练表现更好。
4.4 专家对照:Bigfish 更能体现多任务适应的价值
专家模型只训练一个游戏 50M 步;联合模型总计训练六个游戏 300M 步,因此每个游戏约获得相同的环境交互量。表 4 的测试原始回报为:
| 游戏 | Fake SR 联合训练 | Fake SR 专家 | SRWM 联合训练 | SRWM 专家 |
|---|---|---|---|---|
| Bigfish | 4.7 (2.4) | 15.8 (1.7) | 9.0 (2.0) | 14.2 (2.0) |
| Starpilot | 49.6 (2.1) | 52.9 (1.2) | 54.6 (2.4) | 57.3 (1.6) |
来源:Sec. 4.3,PDF p. 7,表 4。
Bigfish 专家模型中,自修改没有带来更高的测试均值;但联合训练时,SRWM 明显缩小了相对于专家模型的损失。这支持了作者的解释:自修改可缓解同一模型适应多个游戏时的困难。它仍没有达到单任务专家的 Bigfish 表现。Starpilot 中,自修改在专家与联合训练两种条件下都有收益。
4.5 重置消融:跨截断窗口保留状态很重要
若训练和评估时都每 50 步重置自修改状态,SRWM 的训练/测试聚合得分变为 28.5 (1.2) / 16.1 (2.2),接近没有自修改的 Fake SR。正常 SRWM 则为 34.6 (1.8) / 20.0 (1.8)。(Sec. 4.3,PDF p. 7;表 9,PDF p. 17)
因此,虽然梯度只反向传播 50 步,前向运行中累积的权重变化仍需要跨越这个窗口保留。实现时若把 detach 状态误写为 reset 状态,就会改变论文所研究的模型。这项消融同时改变了训练与评估中的重置策略,因而衡量的是整套状态持久性设计。
4.6 附录:更难的分类任务与真正需要记忆的 RL
FC100 体现了通用结构与任务专门设计之间的差距。 在 5-way 5-shot 条件下:
| 方法 | 视觉编码器 | 准确率 % |
|---|---|---|
| ProtoNet Cosine* | Res-12-512 | 40.9 ± 0.6 |
| ProtoNet Cosine Scaled* | Res-12-512 | 51.0 ± 0.6 |
| TADAM* | Res-12-512 | 56.1 ± 0.4 |
| DeltaNet | Conv-4-32 | 43.2 ± 0.1 |
| SRWM | Conv-4-32 | 44.5 ± 0.1 |
| SRWM | Res-12-256 | 46.3 ± 0.1 |
来源:Appendix B.4,PDF pp. 14–15,表 5;星号为引用结果。SRWM 更换更强视觉编码器后有所改善,但仍落后于带尺度参数的 ProtoNet 和 TADAM。作者认为还需要少样本任务专门调优。
必须使用 v2 的修正值。 Appendix B.4 的脚注(PDF p. 14)说明早期预印本曾把 Conv-4-32 的 FC100 准确率报告为 57.1%,原因是 meta-test 数据打乱过程存在 bug;本版本修正为 44.5%,并称已重新运行重要实验。两者会导致完全不同的方法定位。
ProcGen memory 使用的是 SR-DeltaNet。 它用 SRWM 替换 DeltaNet 的慢权重投影,同时保留一块独立的快权重记忆。于是,模型既能改变生成更新指令的部分,也有专门的短期记忆;不能将此结果当作纯 SRWM 的 memory 测试。
memory 实验包含 Dodgeball、Heist、Maze、Miner 四个部分可观测环境,总计 800M 步、每游戏 200M;训练关卡为 0–499,反向传播跨度为 100 步,使用 hard 分布的归一化常数。测试仍是 3 次训练与 3 个固定测试关卡集。(Appendix C.1,PDF pp. 16–17)
| 模型 | 训练聚合得分 | 测试聚合得分 |
|---|---|---|
| DeltaNet | 51.8 (2.6) | 38.0 (4.1) |
| SR-DeltaNet | 59.0 (2.1) | 38.5 (3.2) |
来源:PDF p. 17,表 8。训练提升 7.2 点,测试只提升 0.5 点。表 10(p. 18)中,测试 Heist 从 0.8 升至 1.1,Dodgeball 从 6.4 降至 6.2,Maze 同为 3.3,Miner 从 29.2 升至 29.4。证据支持改善训练拟合,但此处测试泛化优势很小;作者将其定位为初步实验。
五:结论——可学习的自修改机制及其实际取舍
SRWM 的贡献在于提供了一个简洁的闭环:用当前权重生成地址与学习率,从自身读取目标内容,再把差值写回自身。这样,任务内学习不仅改变预测函数,也能改变以后如何生成更新。外积与 delta 规则使这一想法可以嵌入标准深度网络,并通过常规反向传播训练初始状态。
实验中最有说服力的链条是:单任务少样本验证机制能学成;连续输入实验验证分布切换后仍能利用反馈;多任务 RL 中 Fake SR 与重置消融表明,自修改及其持续累积确实影响表现。与较强的 DeltaNet 相比,优势则更有限、更依赖任务设置。
实际采用时有三个具体取舍。
- 矩阵状态带来容量,也带来搬运成本。 Sec. 5 指出,宽度为 $d$ 的矩阵状态有 $O(d^2)$ 个动态变量,而常规 RNN 隐状态通常为 $O(d)$。单 P100 的 RL 设置中,FF/LSTM 约 3500 steps/s,DeltaNet 约 2300,SRWM 约 1700;作者将部分开销归因于 actor/learner 模式之间的状态复制。1-shot Omniglot、batch 128、共用 Conv-4 时,LSTM、DeltaNet、SRWM 则都约 8000 images/s。线性序列复杂度不能直接替代实际吞吐评估。(PDF pp. 7–8)
- 适应能力不等于稳定可解释的学习算法。 门值、key/query 地址和读取差值共同决定更新。较难的训练配置会学成“猜未使用标签”的行为,缺少真正的反馈利用。下一步有价值的分析是追踪不同任务中各行块如何变化,并对生成 key、query、学习率的部分分别做消融。
- 已有应用范围仍集中在较小的任务适应模型。 主实验没有把视觉编码器全部自修改,也没有验证大规模语言建模。纯 SRWM 的任务适应与 SR-DeltaNet 的记忆实验应分别理解。要论证持续自我改进,还需要直接测量学习效率随自修改是否改善,并检查更长轨迹、更多连续切换及返回旧任务时的行为。(Sec. 5–6,PDF pp. 7–9;后续实验建议为本次分析)
对后续模型设计的启发是:把“更新指令从哪里来”当作可学习、可随上下文变化的对象。SRWM 给出了一个具体实现;本文的实验说明这个方向能够工作,也说明持久状态、训练成功率和实际计算成本同样决定其价值。