Similarity of Neural Network Representations Revisited:中文精读笔记
- 作者:Simon Kornblith、Mohammad Norouzi、Honglak Lee、Geoffrey Hinton(Google Brain);ICML 2019。
- 版本:arXiv:1905.00414v4,2019-07-19;本次获取与研读:2026-09-20。
- 材料:论文主页、本地原文 PDF、作者主 TeX。同版本 PDF 与 TeX 均已下载;正文 1–7 节、附录 A–F 全部纳入阅读,关键图表用最终 PDF 核验。参考文献用于定位背景,未逐篇阅读被引论文。
- 页码约定:以下均为 PDF 文件从 1 开始的页码;正文 pp.1–8,参考文献 pp.9–11,附录 pp.12–20。
论文总览
本文研究如何比较两个网络对同一批样本形成的内部表征。它把问题从“找一组线性变换使神经元对齐”转为“两个网络是否认为同样的样本彼此相似”,采用中心化核对齐(Centered Kernel Alignment,CKA)比较样本 Gram 矩阵。
最关键的贡献是对“什么变化应该被相似度忽略”的论证:神经元置换、正交旋转和整体缩放应被忽略;任意可逆线性变换会抹掉方向间相对尺度,甚至使宽表征上的指标退化。线性 CKA 保留大方差方向的权重,且无须做 SVD。CKA、核对齐和 RV 系数有既有统计学历史,不能把论文的贡献写成从零发明这一统计量;贡献在于将其用于网络表征比较、阐明与 CCA 的关系并系统验证。
最直接的实验是同构 CNN 的层匹配:线性 CKA 为 99.3%,线性回归为 45.4%,平方相关形式的 CCA 为 10.6%。这是“找回对应层”的准确率,不是 CIFAR-10 分类准确率(Sec.6.1,p.6,Table 2)。Transformer 附录显示结果依赖取表征的位置,不能概括为 CKA 在所有场景都胜过 CCA。
结构地图
| 原文章节 | 论证作用 | PDF 定位 |
|---|---|---|
| 1 Introduction / Problem Statement | 问题、输入与贡献 | pp.1–2 |
| 2 What Should Similarity Be Invariant To? | 不变性选择与退化定理 | pp.2–3;Theorem 1,Fig.1 |
| 3 Comparing Similarity Structures | Gram、HSIC、CKA 与核选择 | pp.3–4;Eqs.(1)–(4) |
| 4 Related Similarity Indexes | 回归、CCA、SVCCA、PWCCA 等 | pp.4–5;Table 1,Eqs.(5)–(10) |
| 5 Linear CKA versus CCA and Regression | 谱解释与统一关系 | pp.5–6;Eqs.(11)–(14) |
| 6.1 A Sanity Check for Similarity Indexes | 同构网络层匹配 | p.6;Fig.2,Table 2 |
| 6.2 Using CKA to Understand Network Architectures | 深度、残差、跨架构和宽度 | pp.6–7;Figs.3–6 |
| 6.3 Similar Representations Across Datasets | 跨训练数据集比较 | p.8;Fig.7 |
| 6.4 Analysis of the Shared Subspace | 共享的主要谱方向 | p.8;Fig.8 |
| 7 Conclusion and Future Work | 贡献与开放问题 | p.8 |
| A / B | 退化与正交化证明 | p.12 |
| C CCA and Linear Regression | 回归、CCA、PWCCA 关系推导 | pp.12–14 |
| D Notes on Other Methods | Canonical ridge、Procrustes | pp.14–16 |
| E Architecture Details | Tiny、Plain、Width 架构 | p.17;Tables E.1–E.3 |
| F Additional Experiments | Transformer 与补充控制 | pp.18–20;Table F.1,Figs.F.1–F.8 |
一:动机——为什么“能线性互相转换”还不够?
直接比较神经元有坐标依赖:两个网络即使只交换神经元顺序,逐元素比较也可能认为差别很大。CCA 允许两侧线性重参数化,解决了坐标问题,却同时消除了各方向的相对尺度。
作者强调两个理由。第一,梯度下降在不同特征尺度下的学习动态不同;保持函数输出的重参数化,并不保证训练过程相同。第二,不同随机初始化的网络有相近的大主成分(Fig.1,p.2),相对尺度可能承载稳定结构。完全白化会把强信号方向与微弱方向置于相同地位。
1.1 不变性与代价
| 变化 | 线性 CKA | 本文的解释 |
|---|---|---|
| 神经元置换、正交旋转 | 不变 | 消除坐标选择;保留样本内积 |
| 整个表征乘同一个正标量 | 不变 | 不应仅因整体放大而变得不相似 |
| 单独缩放各特征 | 一般改变 | 保留方向间的相对重要性 |
| 任意可逆线性变换 | 一般改变 | 避免过强不变性造成信息丢失 |
若既要求任意正交变换不变,又要求任意逐特征缩放不变,由变换矩阵的 SVD 就得到任意可逆线性变换不变;不能同时保留所有这些要求并指望指标仍对谱尺度敏感。
1.2 Theorem 1 的精确条件与证明
原命题:令 $X,Y\in\mathbb R^{n\times p}$,二者都满足 $\operatorname{rank}(X)=\operatorname{rank}(Y)=n$;若第一参数对任意可逆右乘不变,则对任意 $Z$,有 $s(X,Z)=s(Y,Z)$(Sec.2.1,p.2;Appendix A,p.12)。
证明核心:将 $X,Y$ 的行分别补成 $p\times p$ 可逆矩阵 $X',Y'$,设 $A=(X')^{-1}Y'$,得到 $XA=Y$。任何能被不变变换相连的表征都落入同一等价类,指标无从区分。
条件不能省略:仅有 $p\ge n$ 并不保证满行秩。另一个细节是正文预设列中心化后秩最多为 $n-1$,不能直接同时声称“已中心化且秩为 $n$”。本次分析的解释是先限制到 $\mathbf1^\perp$ 的 $n-1$ 维有效样本空间,再应用同样论证;两个表征若都张满该空间,CCA 的有效典型相关会全部为 1。这里的 $n-1$ 解释是对原定理与中心化约定的衔接,不是原文另一个定理。CKA 避开的是这个不变性退化,不是保证任何高维小样本估计都可靠。
二:方法——从样本关系到归一化谱重合
2.1 输入、输出与计算流程
| 符号 | 含义 / 维度 |
|---|---|
| $X,Y$ | 同一批、同一顺序样本的两组激活,$n\times p_1$ 与 $n\times p_2$ |
| $H=I_n-\mathbf1\mathbf1^T/n$ | $n\times n$ 中心化矩阵 |
| $K,L$ | $n\times n$ 样本核矩阵,线性核时为 $XX^T,YY^T$ |
| $Q_X,Q_Y$ | 各自列空间的正交基,秩亏时使用有效秩 |
| $\lambda_X^i,\mathbf u_X^i$ | $XX^T$ 的特征值及单位特征向量 |
| $\|\cdot\|_F$ | Frobenius 范数;平方为元素平方之和 |
流程:固定模型与评估样本 → 提取选定层的激活 → 按特征减去样本均值 → 计算两个样本关系矩阵 → 中心化与归一化内积 → 得到一个标量。对所有层对重复可得到热图。CKA 是训练后分析量,不是本文提出的新训练损失,也不会直接输出神经元的一一映射。
2.2 样本比较与特征比较的等价性
左侧把两张“哪些样本相似”的矩阵对齐;右侧累加所有跨网络特征对的内积平方。这个恒等式使不同宽度可比较,也允许按维度选择更经济的计算方式(Eq.(1),p.3)。它不是先对神经元进行匹配再打分。
2.3 HSIC 与 CKA
对于 $K_{ij}=k(x_i,x_j)$、$L_{ij}=l(y_i,y_j)$,原文使用的经验 HSIC 为
归一化后
令 $K_c=HKH,L_c=HLH$,它就是 $\langle K_c,L_c\rangle_F/(\|K_c\|_F\|L_c\|_F)$:中心化 Gram 矩阵的余弦相似度。对非退化半正定核矩阵,此形式在 $[0,1]$ 内;零分母时未定义。HSIC 的独立性解释需要相应核与总体条件,不能把有限样本的低线性 CKA 直接解释成统计独立,更不能把 CKA 当作互信息(Sec.3,pp.3–4)。
对已经列中心化的激活,线性 CKA 简化为
特征形式不需要 SVD,若显式计算,时间量级为 $O(n(p_1^2+p_2^2+p_1p_2))$;样本 Gram 形式约为 $O(n^2(p_1+p_2))$,但要存储 $n\times n$ 矩阵。这是本次复杂度分析,论文没有给出统一运行时间 benchmark。
RBF 核为 $\exp(-\|x_i-x_j\|^2/(2\sigma^2))$;作者对每种表征以样本距离中位数的某个比例选择 $\sigma$。其整体缩放不变性依赖带宽同步缩放,固定绝对带宽时不能无条件宣称该性质。本文多数实验线性核与 RBF 接近,但具体结果对带宽仍有差异。
2.4 CCA、回归、SVCCA、PWCCA 的角色
在满列秩且 $p_1\le p_2$ 的记号下,
其中典型相关 $\rho_i$ 是 $Q_X^TQ_Y$ 的奇异值,核范数 $\|\cdot\|_*$ 是奇异值之和。秩亏实现须用有效基与相应维数,不能直接求奇异的协方差逆。
线性回归以 $Y$ 拟合 $X$:
$$R^2_{\rm LR}=1-\frac{\min_B\|X-YB\|_F^2}{\|X\|_F^2} =\frac{\|Q_Y^TX\|_F^2}{\|X\|_F^2}.$$它只对白化预测端 $Y$ 的任意基变换不变,本身不对称。SVCCA 先保留达到累计解释方差阈值的主成分再 CCA;只有保留子空间不变时才继承可逆线性不变性。PWCCA 用典型变量在原特征上的绝对投影构造权重,通常不对称,也不是正交不变指标。附录 C.3 证明,将 PWCCA 的投影及相关系数都平方后,恰可还原上述回归统计量;这不等于原 PWCCA 与回归完全相同(Table 1,p.4;Appendix C,pp.12–14)。
2.5 谱视角:CKA 到底保留了什么?
写 $X=U_X\Sigma_XV_X^T$,$Y=U_Y\Sigma_YV_Y^T$,$\lambda$ 是奇异值的平方,则
CCA 衡量子空间重合,对不同谱方向等权;CKA 对两侧都按特征值加权。它并不是“每个 canonical correlation 简单乘一个权重”的逐项同一公式,而是在样本空间的特征向量两两内积上建立的对应关系(Eqs.(13)–(14),p.5)。
教学例子(非论文实验):取两个正交、零均值样本向量 $u,v$,令 $X=[10u,v]$、$Y=[u,10v]$。二者有完全相同的列空间,所以 CCA 为 1;但线性 CKA 为 $200/10001\approx0.0200$。它们主要区分样本的方向不同,正是 CKA 要保留的差别。高 CCA 不等于保留相对方差结构。
2.6 附录推导与原文疑似笔误
附录 B 说明,对输入先取正交基后应用正交不变指标,会得到可逆线性不变性;因此“先白化再 CKA”改变了分析问题。原 Eq.(11) 为 $R^2_{\rm CCA}=\operatorname{CKA}(Q_XQ_X^T,Q_YQ_Y^T)\sqrt{p_2/p_1}$,异维情况下不能省掉该因子。
Eq.(12) 核对(p.5):PDF 与 TeX 均把回归关系的因子写成 $\sqrt{p_1}\|X^TX\|_F/\|X\|_F^2$。按其已定义的 $Q_Y\in\mathbb R^{n\times p_2}$,$\|Q_Y^TQ_Y\|_F=\sqrt{p_2}$,故应为
$$R^2_{\rm LR}=\operatorname{CKA}(XX^T,Q_YQ_Y^T) \frac{\sqrt{p_2}\|X^TX\|_F}{\|X\|_F^2}.$$这是本次代数核验发现的疑似笔误;$p_1=p_2$ 时无差别。一般秩亏情况用 $\sqrt{\operatorname{rank}(Y)}$。本笔记与幻灯片使用直接投影公式,避免将原式错误因子传播到后续解释。
附录 D.1 的 canonical ridge 用 $\lambda/(\lambda+\kappa)$ 平滑控制白化程度。适当归一化后,零正则可还原 CCA;单侧大正则配合相应归一化可还原回归;双侧共同大正则、使用可分离归一化,可趋于线性 CKA。归一化方式不同,极限结论不能混用。作者认为正则超参数增加了探索分析的选择成本,预测映射的交叉验证最优也不自动等于相似度解释最优。
附录 D.2 在等宽正交 Procrustes 设置中,通过最大化 $\operatorname{tr}(Y^TXQ)$ 得到 $\|Y^TX\|_*$;CKA 的分子则是平方 Frobenius 范数。因此两者对奇异值的聚合方式不同,不能直接互换。
三:实验——先区分问题、数据与指标
| 实验 | 模型 / 样本 | 评价目的与协议 |
|---|---|---|
| Sec.6.1 CNN sanity check | 10 个 Tiny-10;CIFAR-10 训练集激活 | 对每层寻找另一模型的最相似层;排除 logits;不同模型及层间平均 |
| Sec.6.2 深度 | Plain-10/18/34/66;CIFAR-10 测试集 | 同网层对 CKA;逐层训练 $\ell^2$ 正则 logistic probe 辅助核验解释 |
| Sec.6.2 残差 / 跨架构 | ResNet-62,以及 Plain 与不同 ResNet | 测试集激活;检查残差位置与架构层对应 |
| Sec.6.2 宽度 | Width-$n$,最大宽度 4096;10 个模型 | 同宽异初始化及对最宽模型;误差带为 jackknife 标准误 |
| Sec.6.3 跨数据集 | CIFAR-10 / CIFAR-100 训练模型与未训练模型 | 分别在同一 CIFAR-10 或同一 CIFAR-100 测试输入上比较 |
| Sec.6.4 共享子空间 | Tiny-10 的 conv1、conv4、平均池化层 | 看另一模型 Gram 对本模型特征向量的缩放与旋转 |
| Appendix F.1 Transformer | WMT18 英德翻译;10 个编码器、45 对 | 12 个交替 Attention/FFN 子层,4 个取激活位置 |
Tiny-10 的通道依次使用 16、32、64,含全局平均池化;平均 CIFAR-10 分类准确率为 89.4%。Plain 模型使用 96、192 通道。宽度实验是各卷积层统一宽度的另一系列,不能直接当成 Tiny-10 的所有层等比缩放(Appendix E,p.17)。正文与附录没有完整列出各实验所有优化器、学习率、epoch、随机种子、数据增强和 probe 正则搜索细节,本笔记不补造。
层匹配指标越高越符合作者的“同构网络应找回同一层”的 sanity check;它是合理的检验假设,并非所有语义相似性的独立真值。CKA 值高表示指定样本和核下关系结构更一致,不是性能越高。
四:结果——按原文问题逐项阅读
4.1 同构 CNN:对应层结构清晰(Sec.6.1)
| 指标 | 层匹配准确率(%,越高越好) |
|---|---|
| CCA:平均相关 | 1.4 |
| CCA:平均平方相关 | 10.6 |
| SVCCA:平均相关 | 9.9 |
| SVCCA:平均平方相关 | 15.1 |
| PWCCA | 11.1 |
| 线性回归 | 45.4 |
| 线性 HSIC | 22.2 |
| 线性 CKA | 99.3 |
| RBF CKA,带宽系数 0.2 | 80.6 |
| RBF CKA,带宽系数 0.4 | 99.1 |
| RBF CKA,带宽系数 0.8 | 99.3 |
来源:Table 2,p.6。SVCCA 阈值为 0.99;PWCCA 和回归以 $S+S^T$ 对称化。原表以 jackknife z-test、$p<0.05$ 判断与最佳是否有显著差别,线性 CKA 与 RBF 0.4/0.8 都属于未显著差于最佳的组,不能把 99.3 对 99.1 写成有统计支持的优胜。线性 CKA 对回归提高 53.9 个百分点。
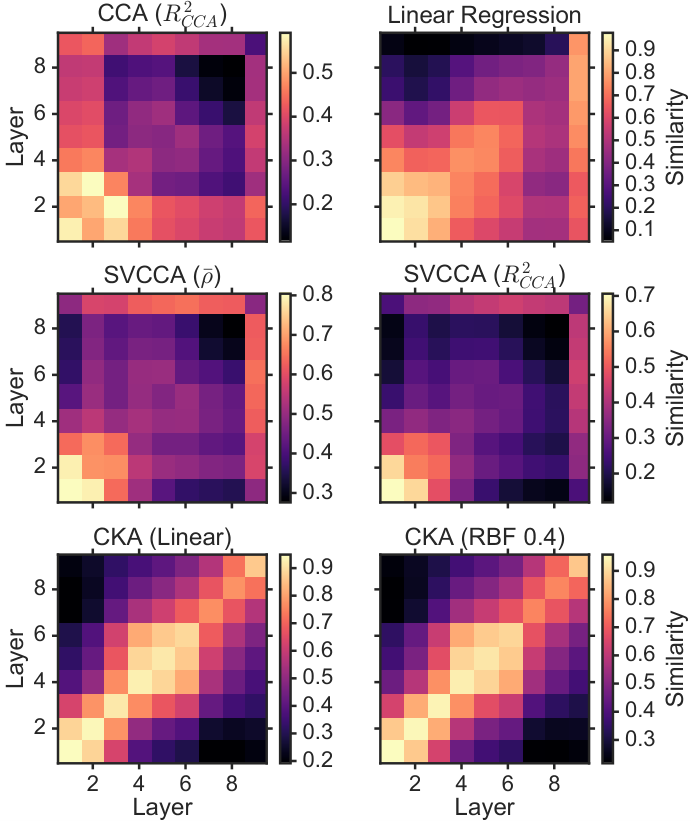
原 Fig.2,p.6。横纵轴是两网络层号,各面板比较不同指标;亮色表示更高相似度。CKA 面板的高相似度带沿对应层分布。不同面板色条不同,不能仅凭视觉亮度直接比较不同指标的数值。
4.2 深度、残差与跨架构(Sec.6.2)
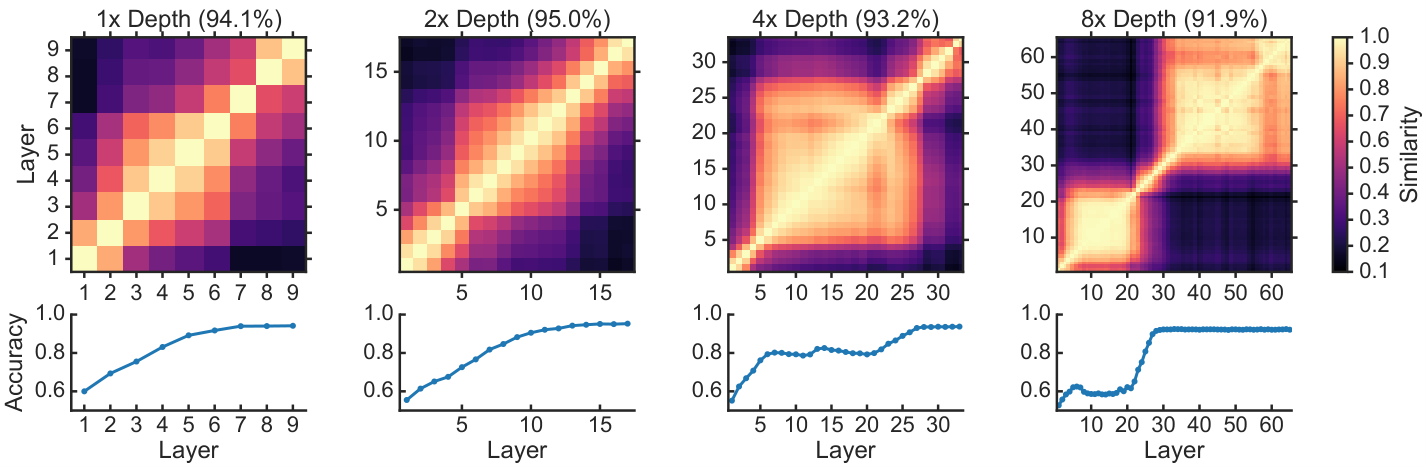
原 Fig.3,p.7。上排是各模型内部层对 CKA,下排为同一模型各层的 logistic probe 分类准确率。图中四个单独模型的最终准确率依次为 94.1%、95.0%、93.2%、91.9%。深度增加 2 倍改善性能,8 倍模型超过一半后层彼此相近且 probe 性能较早平台化,支持这些后层没有持续改善可线性利用的表示。
不要与 Appendix E 的跨模型平均准确率混用:Plain-10/18/34/66 均值为 93.9%、94.8%、93.7%、91.3%(Table E.2,p.17)。图中样例与均值不同不是数据矛盾。CKA 与 probe 相互印证,但不能单凭此证明删层后可保持性能,需要干预实验。
Fig.4(p.7)中的 ResNet-62 有格子结构:残差加法后的激活更相近,块内激活表现不同;同分辨率 block group 更相近。这里没有观察到 Plain 深网相同的退化形态,不等于证明所有 ResNet 都不会退化。
Fig.5(p.7)比较 Plain-10/18 与 ResNet-14/32。相似带支持作者“更深网络像在旧层之间插入新层”的解释;这是表征对应的可视化,不是权重相同或模块可无损替换的证据。附录 F.5(p.20,Fig.F.8)在 训练集 上比较 Tiny-10 与 ResNet-14,CKA 比其他指标显示更清晰对应,使用训练集是为了给对样本数敏感的 CCA 系列更好的条件。
4.3 宽度:早层先饱和(Sec.6.2)
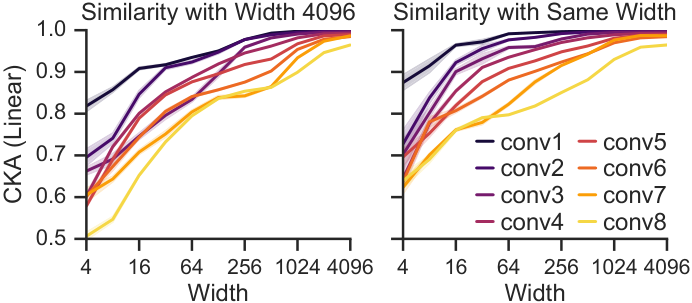
原 Fig.6,p.7。横轴为宽度,纵轴为线性 CKA;颜色区分 conv1–conv8。左面板与宽度 4096 的网络比,右面板与同宽异初始化网络比。总体上网络越宽越相似,早层达到高相似度需要的宽度更小;网络通常更像同宽模型,而非最宽模型。误差带为 jackknife 标准误。这里是有限宽度实证趋势,不是“无限宽必然学习唯一表征”的证明,亦未给每个点的独立数表,不伪造曲线精确值。
4.4 跨数据集:训练形成相似早层(Sec.6.3)
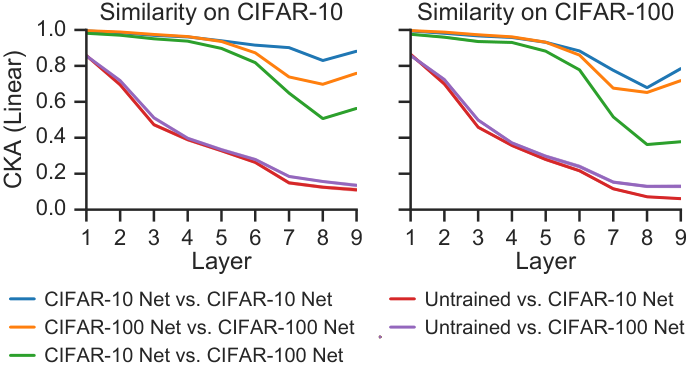
原 Fig.7,p.8。横轴为对应层号,纵轴为 CKA;两面板分别用 CIFAR-10、CIFAR-100 测试输入。曲线区分两网络各自训练数据集及是否未训练。跨数据集训练模型的早层相近、晚层差异增大,与未训练模型的相似度下降更明显,支持相似早层包含训练所形成的结构。
这里每次比较仍把同一批输入送入两网络;不是将 CIFAR-10 的样本逐行对应到 CIFAR-100 的不同样本。两个数据集有相近图像域,不能外推至任意领域。图注写 10 个各类型模型、45 pairs,但没有逐类展开跨类型模型的配对规则,不将其擅自重述为穷举 100 个跨类型组合。
4.5 共享子空间主要在大特征值方向(Sec.6.4)
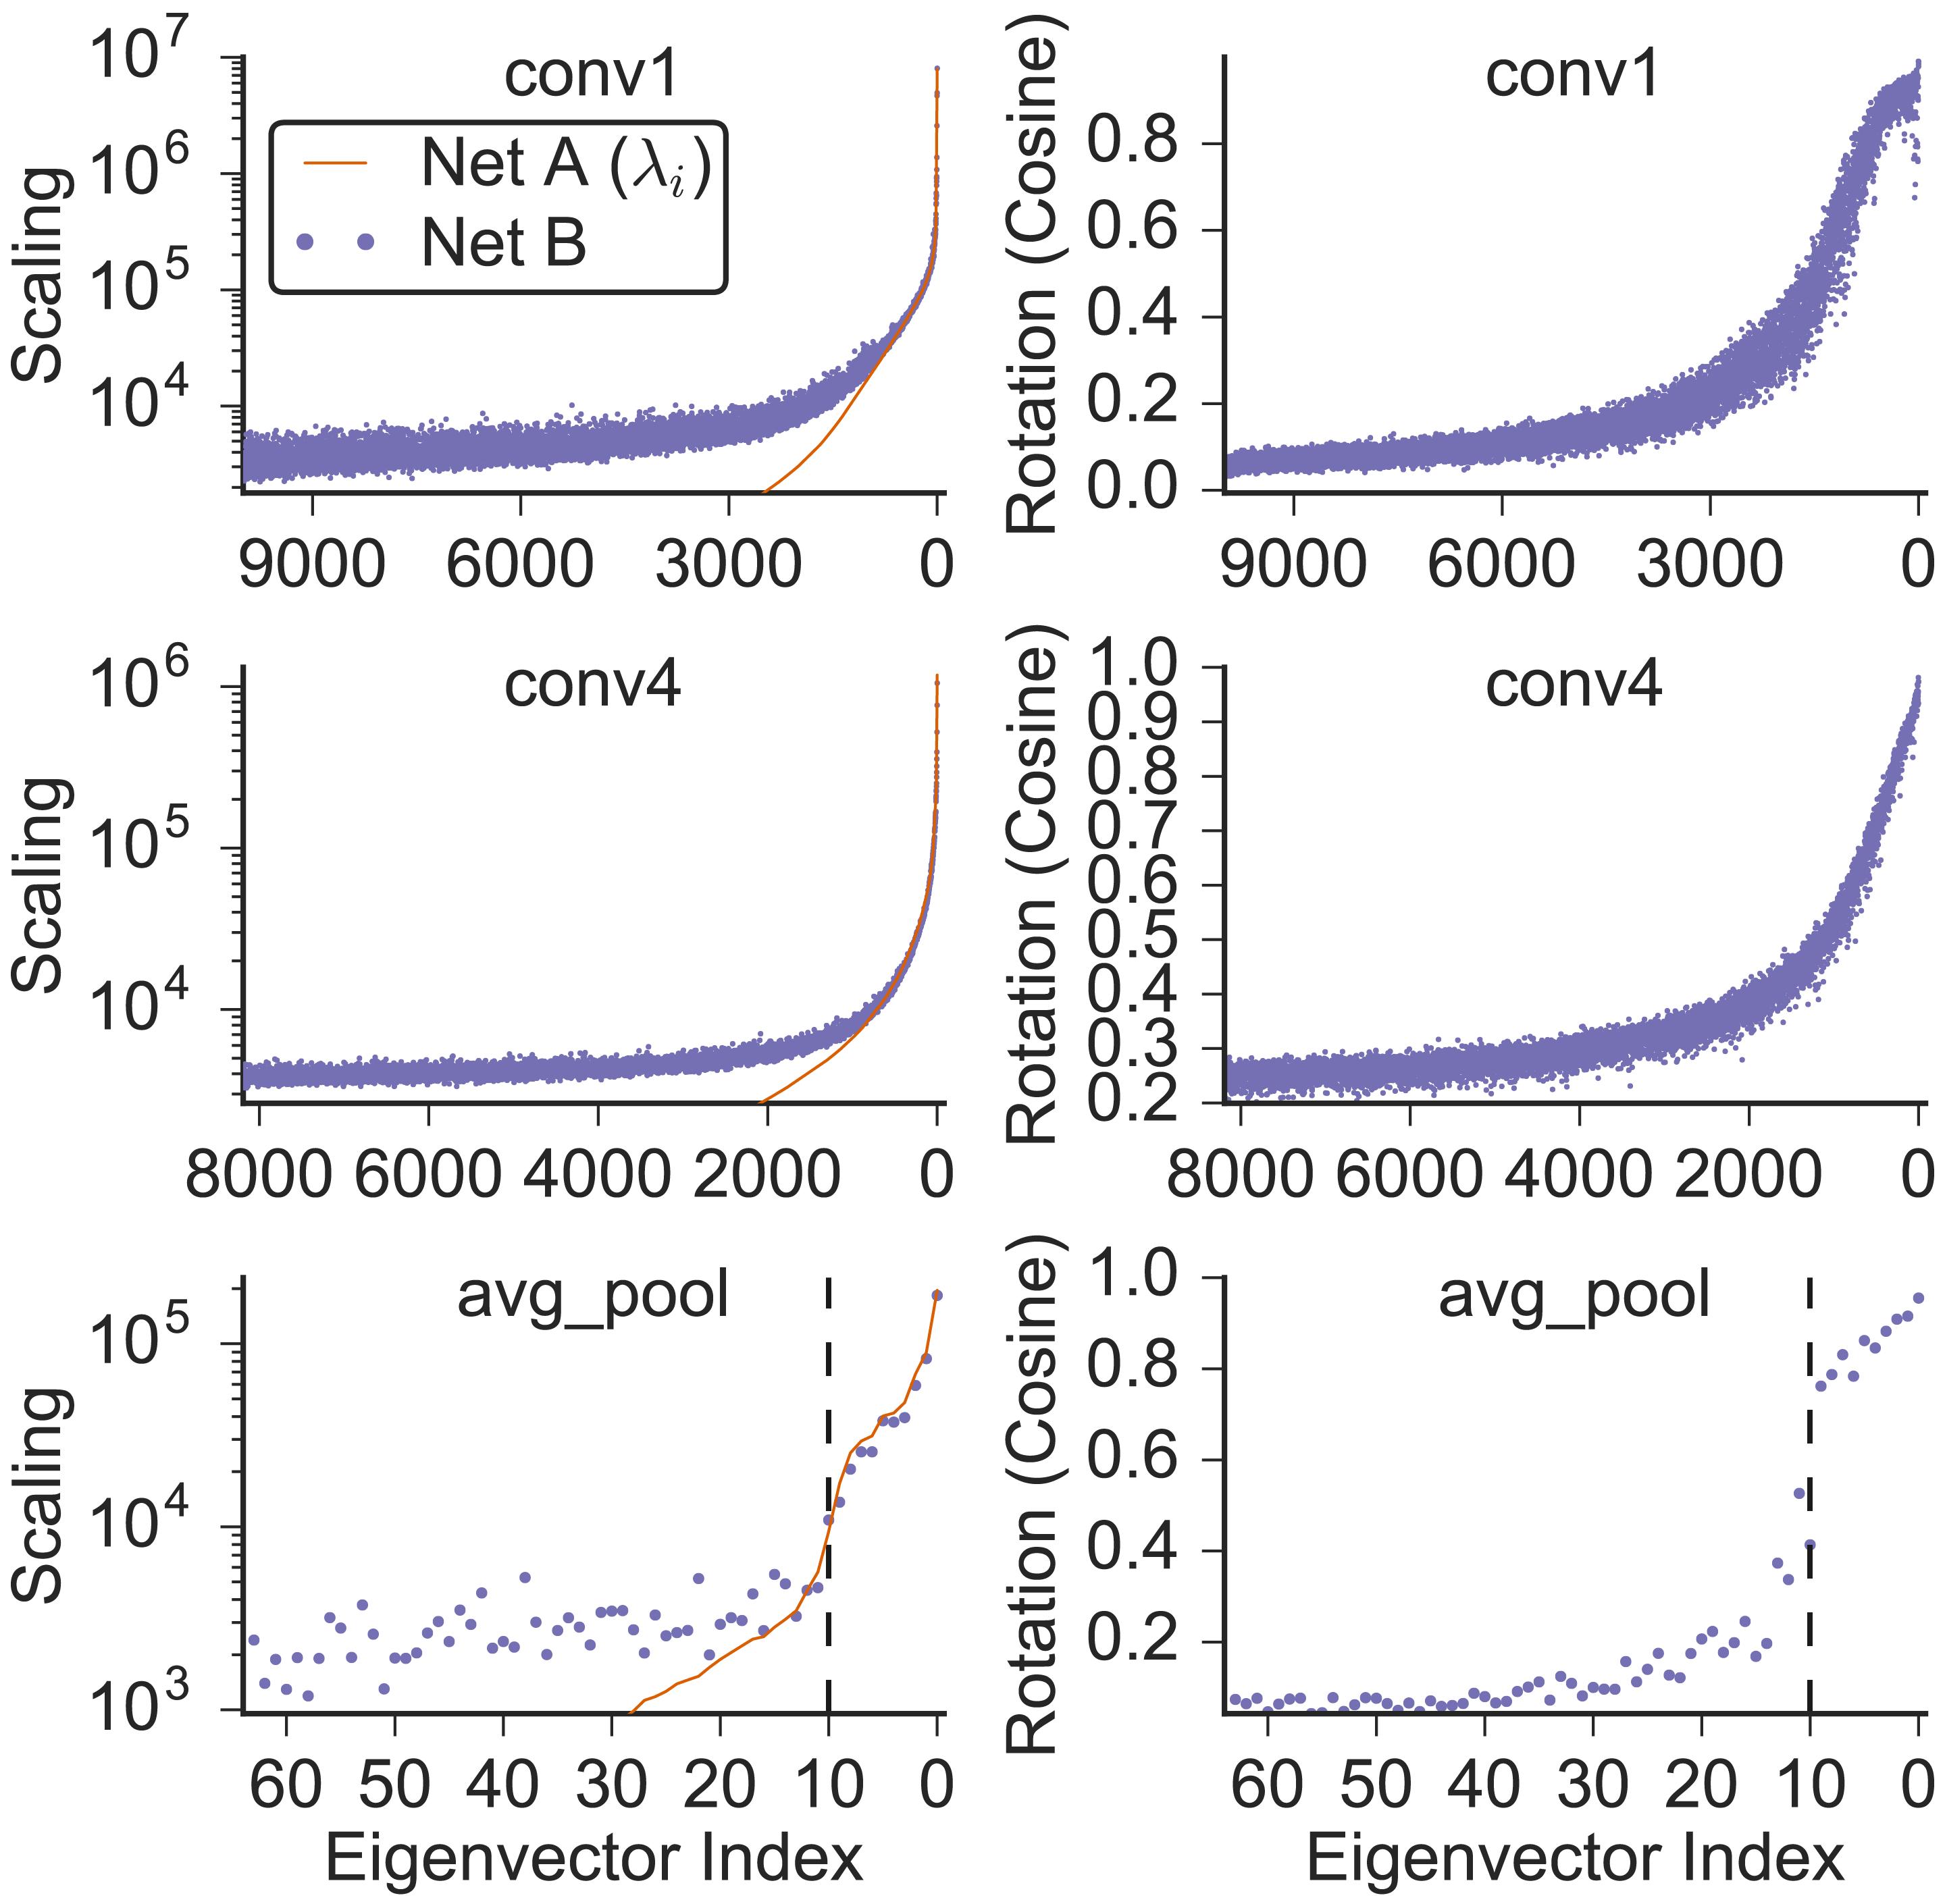
原 Fig.8,p.8。各行是 conv1、conv4 与平均池化层;横轴特征向量索引从大数字向 0 递减,靠右是大的谱方向。左列比较 $\|XX^T u_X^i\|$(本模型特征值)与 $\|YY^T u_X^i\|$;右列为 $u_X^i$ 与 $YY^T u_X^i$ 的方向余弦。大特征值对应方向的缩放与方向更一致,小方向差异较大。
64 维的平均池化层中,共享子空间约为 10 维,与 CIFAR-10 类数相近。这支持 CKA 的大方差加权解释;“约 10 维”是图和作者的经验描述,既不是全部 64 维都对齐,也不是对所有分类网络成立的维数定理。
4.6 Transformer:取激活位置决定结论(Appendix F.1)
训练数据为 WMT18 英德翻译的 Europarl v7、Common Crawl、News Commentary v13。评估使用 newstest2013 的 3,000 句、75,804 个 token,忽略句末 token。编码器包含 12 个 Attention/FFN 交替子层,不是 12 个完整 Attention+FFN 块。每个子层比较 Layer Norm 后、逐通道 Scale 后、Attention/FFN 后、Residual 后四处激活。
| 指标(摘录) | Layer Norm | Scale | Attn/FFN | Residual |
|---|---|---|---|---|
| CCA 平方相关 | 87.8 | 87.8 | 95.3 | 95.2 |
| PWCCA | 88.5 | 88.9 | 96.1 | 87.0 |
| 线性回归 | 78.1 | 83.7 | 76.0 | 36.9 |
| 线性 CKA | 78.6 | 95.6 | 86.0 | 73.6 |
| RBF CKA 0.4 | 92.3 | 96.5 | 89.1 | 98.1 |
来源:Table F.1,p.18;单位为层匹配准确率 %,并非翻译质量。此处不重现原表显著性加粗,不能凭小差异断言显著。所有受测指标都获得非平凡的匹配能力。CCA 在 Scale 前后给相同结果,恰是它忽略逐通道缩放的结果;CKA 可显露跨网络一致的 Attention/FFN 棋盘结构。与此同时,线性 CKA 在 Residual 后远低于 CCA,必须与主文 CNN 的成功同时理解。
4.7 其他控制实验(Appendix F.2–F.4)
- SVCCA 阈值:Fig.F.3(p.19)试了多种阈值,仍未恢复该 CNN 的层结构;这排除“仅仅把 0.99 换成另一测试阈值就能解决”的解释,不证明任何变体都不行。
- 初始化:Figs.F.4–F.5(p.19)显示未训练网络也有由架构带来的相似性结构,与训练网络比较时模式不同;因此不能只看高 CKA 就断言学到了相同任务知识。
- Batch normalization:Fig.F.6(p.19),有/无 BN 的网络仍有相近表征,差异较明显处在最后卷积层。两组分别优化超参数,平均准确率为 93.9% / 91.5%,不能把此作为严格只改 BN 的因果消融。
- 类内比较:Fig.F.7(p.19)按 CIFAR-10 每类分别计算 CKA 后取均值,与全样本热图相近。它表明观察到的结构不只靠类别间分离解释;类内结果依然不能证明所有语义因素已对齐。
五:结论——什么时候这个指标有解释力?
可靠贡献是:给出不变性过强导致退化的理论说明,用中心化样本几何提供可计算的替代指标,并用层匹配、架构、宽度和跨数据集实验展示其解释力。最重要的理解是相似度定义本身就选择了哪些信息值得保留。
需要保留的边界:
- 高 CKA 是指定输入集和核下的相似,不保证模型功能、错误模式、因果机制或分布外行为相同。
- 线性 CKA 更关注大方差方向,这是有证据的设计选择,也可能弱化低方差但任务关键的因素。
- 没有任意可逆变换不变性退化,不代表没有有限样本、维度或核带宽影响;本文没有证明普遍统计可靠性。
- sanity check 依赖“同构对应层更相似”的假设;Transformer 已说明不存在不依赖取层位置的统一赢家。
- 宽度趋势、深度冗余、约 10 维共享空间都受实验范围约束;后续权重合并、剪枝、迁移需要另外验证。
本次分析的使用建议:先确定样本单位和激活位置,确保行对应,明确中心化与是否池化;报告多随机种子及样本敏感性;同时检查 Gram 谱或线性 probe,以免单个标量遮蔽机制。不要默认对每个特征标准化到单位方差,因为那会改变本文刻意保留的尺度结构。对 Transformer 必须注明是在 Layer Norm、缩放、Attention/FFN 还是残差之后取值。上述建议是依据论文的应用推论,不是作者已经执行的完整新实验。
可讨论的问题:改变核或谱权重能否更好反映具体任务?如果两层高 CKA,实际替换模块能否保留行为?低方差方向中的信息会不会被线性 CKA 忽略?这些都是开放问题,不能写成本文的已验证结论。