Sparse Attentive Backtracking:通过回忆实现时间信用分配
题名:Sparse Attentive Backtracking: Temporal Credit Assignment Through Reminding
作者:Nan Rosemary Ke、Anirudh Goyal、Olexa Bilaniuk、Jonathan Binas、Michael C. Mozer、Chris Pal、Yoshua Bengio
版本:arXiv:1809.03702v1,提交于 2018-09-11;获取与研读日期:2026-10-29。
原文:arXiv PDF · 本地 PDF
发表:已发表于 NeurIPS 2018,收录于 Advances in Neural Information Processing Systems 31。正式论文集
代码:作者官方实现,仓库包含模型层与复制任务训练程序;README 标注使用 PyTorch 0.1.12、CUDA 8.0、cuDNN 6。发表与代码信息查证于 2026-10-29。
论文总览
长序列学习有两个不同的难点:模型要能在当前时刻取回很久以前的信息,训练信号还要能回到产生这些信息的计算过程。普通循环网络通过逐步递推完成两件事;截断时间反向传播(truncated back-propagation through time,TBPTT)则切断了远处的直接信用分配路径。
稀疏注意力回溯(Sparse Attentive Backtracking,SAB)的思路是把“想起某段过去”同时变成信息读取和梯度路由:保存部分历史隐藏状态,当前状态只检索其中少量记忆;反向传播沿这些跨时间连接直接抵达过去,再在被选记忆之前做一小段局部 TBPTT。作者把后一过程称为 mental updates。本文用增强 LSTM 实现这一原则。
最鲜明的结果来自复制任务:各自在延迟长度 $T=300$ 上训练时,SAB 的最后 10 个符号准确率为 99.9%,普通 LSTM 的完整 BPTT 基线为 35.9%;只在 $T=100$ 上训练再测试 $T=5000$ 时,SAB 保留 41% 准确率,普通 LSTM 为 12%,全自注意力 LSTM 则报告内存不足。前者检验长依赖能否学会,后者检验能否外推,两组数字来自不同实验。(表 1、表 5,PDF 第 7–8 页。)
这篇论文的主要贡献是展示:短的局部反传可以与远距离信用分配共存,前提是模型能学到有用的跨时间检索路径。 它没有给出常数内存或线性时间的长序列算法:当前实现仍对不断增长的记忆逐项打分,推理时也保存历史记忆。(第 8 节,PDF 第 13 页。)
结构地图
下文的页码均为从 1 开始的 arXiv v1 PDF 页码;本版共有 13 页,表号按这一版本引用。
| 原文章节 | 论证作用 | PDF 页码与关键对象 |
|---|---|---|
| 1 Introduction;1.1 Credit Assignment in Recurrent Neural Networks | 从“回忆”引出长时间信用分配;解释 BPTT 与 TBPTT 的取舍 | 1–3 |
| 1.2 Novel Credit Assignment Mechanism: Sparse Attentive Backtracking | 提出长依赖、迁移、Transformer 比较、稀疏性四组问题 | 3 |
| 2 Related Machine Learning Work | 与跳跃连接、Transformer 注意力的关系 | 3 |
| 3 Sparse Attentive Backtracking;3.1 Sparse retrieval of memories | 记忆保存、打分、稀疏化、状态融合和输出 | 3–5;图 1、算法 1 |
| 3.2 Sparse replay | 跨时间反传与 mental updates | 5–6;图 2 |
| 4 Experimental Setup and Results | 合成任务、字符语言建模、序列图像分类、长度迁移、消融 | 5–8;表 1–5 |
| 5 Conclusions | 核心贡献与更有选择性的记忆机制 | 8 |
| 6 Acknowledgement;References | 致谢与引用文献 | 9–11 |
| 7 Supplementary material,7.1–7.5 | 各任务配置;Text8 的截断自注意力对照 | 12;表 6 |
| 8 Computational Complexity of SAB;8.1 Gradient Flow | 时间/空间开销、递归依赖与梯度裁剪观察 | 13 |
一:动机——把信用传到相关事件,而非逐步穿过整个过去
1.1 前向记忆与反向信用分配是两件事
设普通循环网络为 $\boldsymbol h^{(t)}=f_\theta(\boldsymbol h^{(t-1)},\boldsymbol x^{(t)})$。即使隐藏状态在前向中带着过去的信息,当前损失对早期计算的梯度仍要穿过一串状态转移。以下是帮助理解的链式法则展开,并非论文中的编号公式:
长的雅可比连乘容易导致梯度消失或放大。完整 BPTT 还需要保存并遍历长计算图;TBPTT 把顺序路径截短,减轻计算负担,但截断点之外的事件不能通过这条路径直接收到当前损失的训练信号。截断不意味着前向状态立即遗忘,却会改变哪些早期计算能被当前误差修正。(第 1.1 节,PDF 第 2–3 页。)
1.2 回忆为何有助于学习
论文以“行驶时听到异响,停车后发现轮胎漏气,才重新想起异响”为动机。真正有用的计算是把当前结果与某个相关事件连接,并改善以后对类似异响的处理。SAB 将这个想法落实为两条通路:普通循环边负责连续处理输入,注意力选择的跨时间边负责取回记忆并传递信用。
作者提出四个问题:能否学到长依赖(Q1)、能否迁移到更长序列(Q2)、与 Transformer 如何比较(Q3)、稀疏选择和局部回放是否有用(Q4)。生物记忆提供设计动机;后面的证据来自人工序列任务。(第 1.2 节,PDF 第 3 页。)
1.3 与普通自注意力的关系
SAB 仍然保留 LSTM 的逐步递推。在当前时刻,它对历史状态建立动态跳跃连接,连接数受到预算限制;训练时,又刻意限制从这些历史节点继续回溯的范围。因而应同时观察三个设计维度:存下哪些状态、读出哪些状态、梯度从读出的状态继续走多远。仅在前向中加入稠密 attention,并不能自动得到同样的训练机制。(第 2–3 节,PDF 第 3–5 页。)
二:方法——稀疏读取与局部回放
2.1 三个超参数控制不同的预算
| 符号 | 含义 | 改变它主要影响什么 |
|---|---|---|
| $k_{\mathrm{att}}$ | 每隔多少个时间步保存一个隐藏状态 | 历史记忆的采样密度 |
| $k_{\mathrm{top}}$ | 一次检索最多读出多少条记忆 | 注意力支持集大小、可建立的直接跳跃连接数 |
| $k_{\mathrm{trunc}}$ | 局部顺序反传的长度 | 当前区域及被回忆区域中的信用分配范围 |
| $\mathcal M$,$\boldsymbol m^{(i)}$ | 历史记忆集合及其中一条状态 | 所存内容为增强后的隐藏状态 $\boldsymbol h$ |
| $\hat{\boldsymbol h}^{(t)}$,$\boldsymbol h^{(t)}$ | 临时隐藏状态与融合记忆后的隐藏状态 | 区分 LSTM 原始输出与 SAB 输出 |
| $\boldsymbol c^{(t)}$,$\boldsymbol s^{(t)}$ | LSTM cell state 与检索摘要 | 记忆摘要加到隐藏状态,算法未直接加到 cell state |
较小的 $k_{\mathrm{trunc}}$ 并不限制记忆跳跃的时间距离。例如,当前时刻可以读到几千步以前保存的状态,再只回传它附近的 5 步。$k_{\mathrm{att}}$ 也不是 attention 的执行间隔:算法每步都检索,只是周期性写入。(第 3.1–3.2 节,算法 1,PDF 第 4–5 页。)
2.2 前向第一步:先生成当前查询
临时状态已经整合当前输入与上一步状态,随后被用作检索查询。设隐藏维度为 $n$,则 $\hat{\boldsymbol h}^{(t)},\boldsymbol h^{(t)},\boldsymbol c^{(t)},\boldsymbol m^{(i)},\boldsymbol s^{(t)}\in\mathbb R^n$。算法先读取过去,再决定是否把当前状态写入,因此当前新记忆不会在同一步被自我检索。
2.3 前向第二步:逐条打分,按相对突出程度稀疏化
算法 1 对每条历史记忆计算一个非归一化标量分数:
为说明维度,记打分网络隐藏宽度为 $d_a$,则 $\boldsymbol W_1,\boldsymbol W_2\in\mathbb R^{d_a\times n}$,$\boldsymbol W_3\in\mathbb R^{1\times d_a}$。$\tanh$ 使记忆与当前查询共同决定分数;所有候选记忆都要经过这一打分过程。
将分数降序排列,取第 $k_{\mathrm{top}}+1$ 大的值为阈值 $\tau_t$(即算法中的 $a^{(t)}_{\mathrm{ktop}}$),然后计算:
这里额外引入 $\alpha$ 表示归一化权重,以区分算法中先经 ReLU 的 $\tilde a$。在分母非零且候选充分的情况下,最多 $k_{\mathrm{top}}$ 条记忆得到正权重。与 softmax 不同,低分记忆的读取权重可以恰好为零;高分记忆按“高出淘汰阈值多少”分配份额。
教学例子:若分数为 $[4,3,1,0]$,且 $k_{\mathrm{top}}=2$,则阈值是 1,ReLU 后为 $[3,2,0,0]$,归一化后为 $[0.6,0.4,0,0]$。这既不是保留原分数直接求平均,也不是对保留项做 softmax。
排序支持集不变时,选中权重可以局部求导;支持集改变处带有离散选择边界。算法 1 没有展开空记忆、候选少于 $k_{\mathrm{top}}+1$、分数完全并列导致零分母的处理,这些是落地实现需要补齐的边界情况。按上述精确归一化式,$k_{\mathrm{top}}=1$ 时唯一选中项的权重恒为 1,在排序不变区域内无法通过这个权重的连续变化学习打分;这是由公式得到的特例分析,也说明“可微的稀疏注意力”需要结合具体反向实现理解。(算法 1,PDF 第 5 页。)
2.4 前向第三步:融合记忆并产生输出
输出层同时接收融合后的状态和检索摘要,可分别调整两者对任务输出的影响;后续按任务形成分类分布或其他预测。若 $t\equiv0\pmod{k_{\mathrm{att}}}$,再将 $\boldsymbol h^{(t)}$ 追加到 $\mathcal M$。原文没有设置固定容量或淘汰规则,记忆随序列增长。(第 3.1 节,算法 1,PDF 第 4–5 页。)
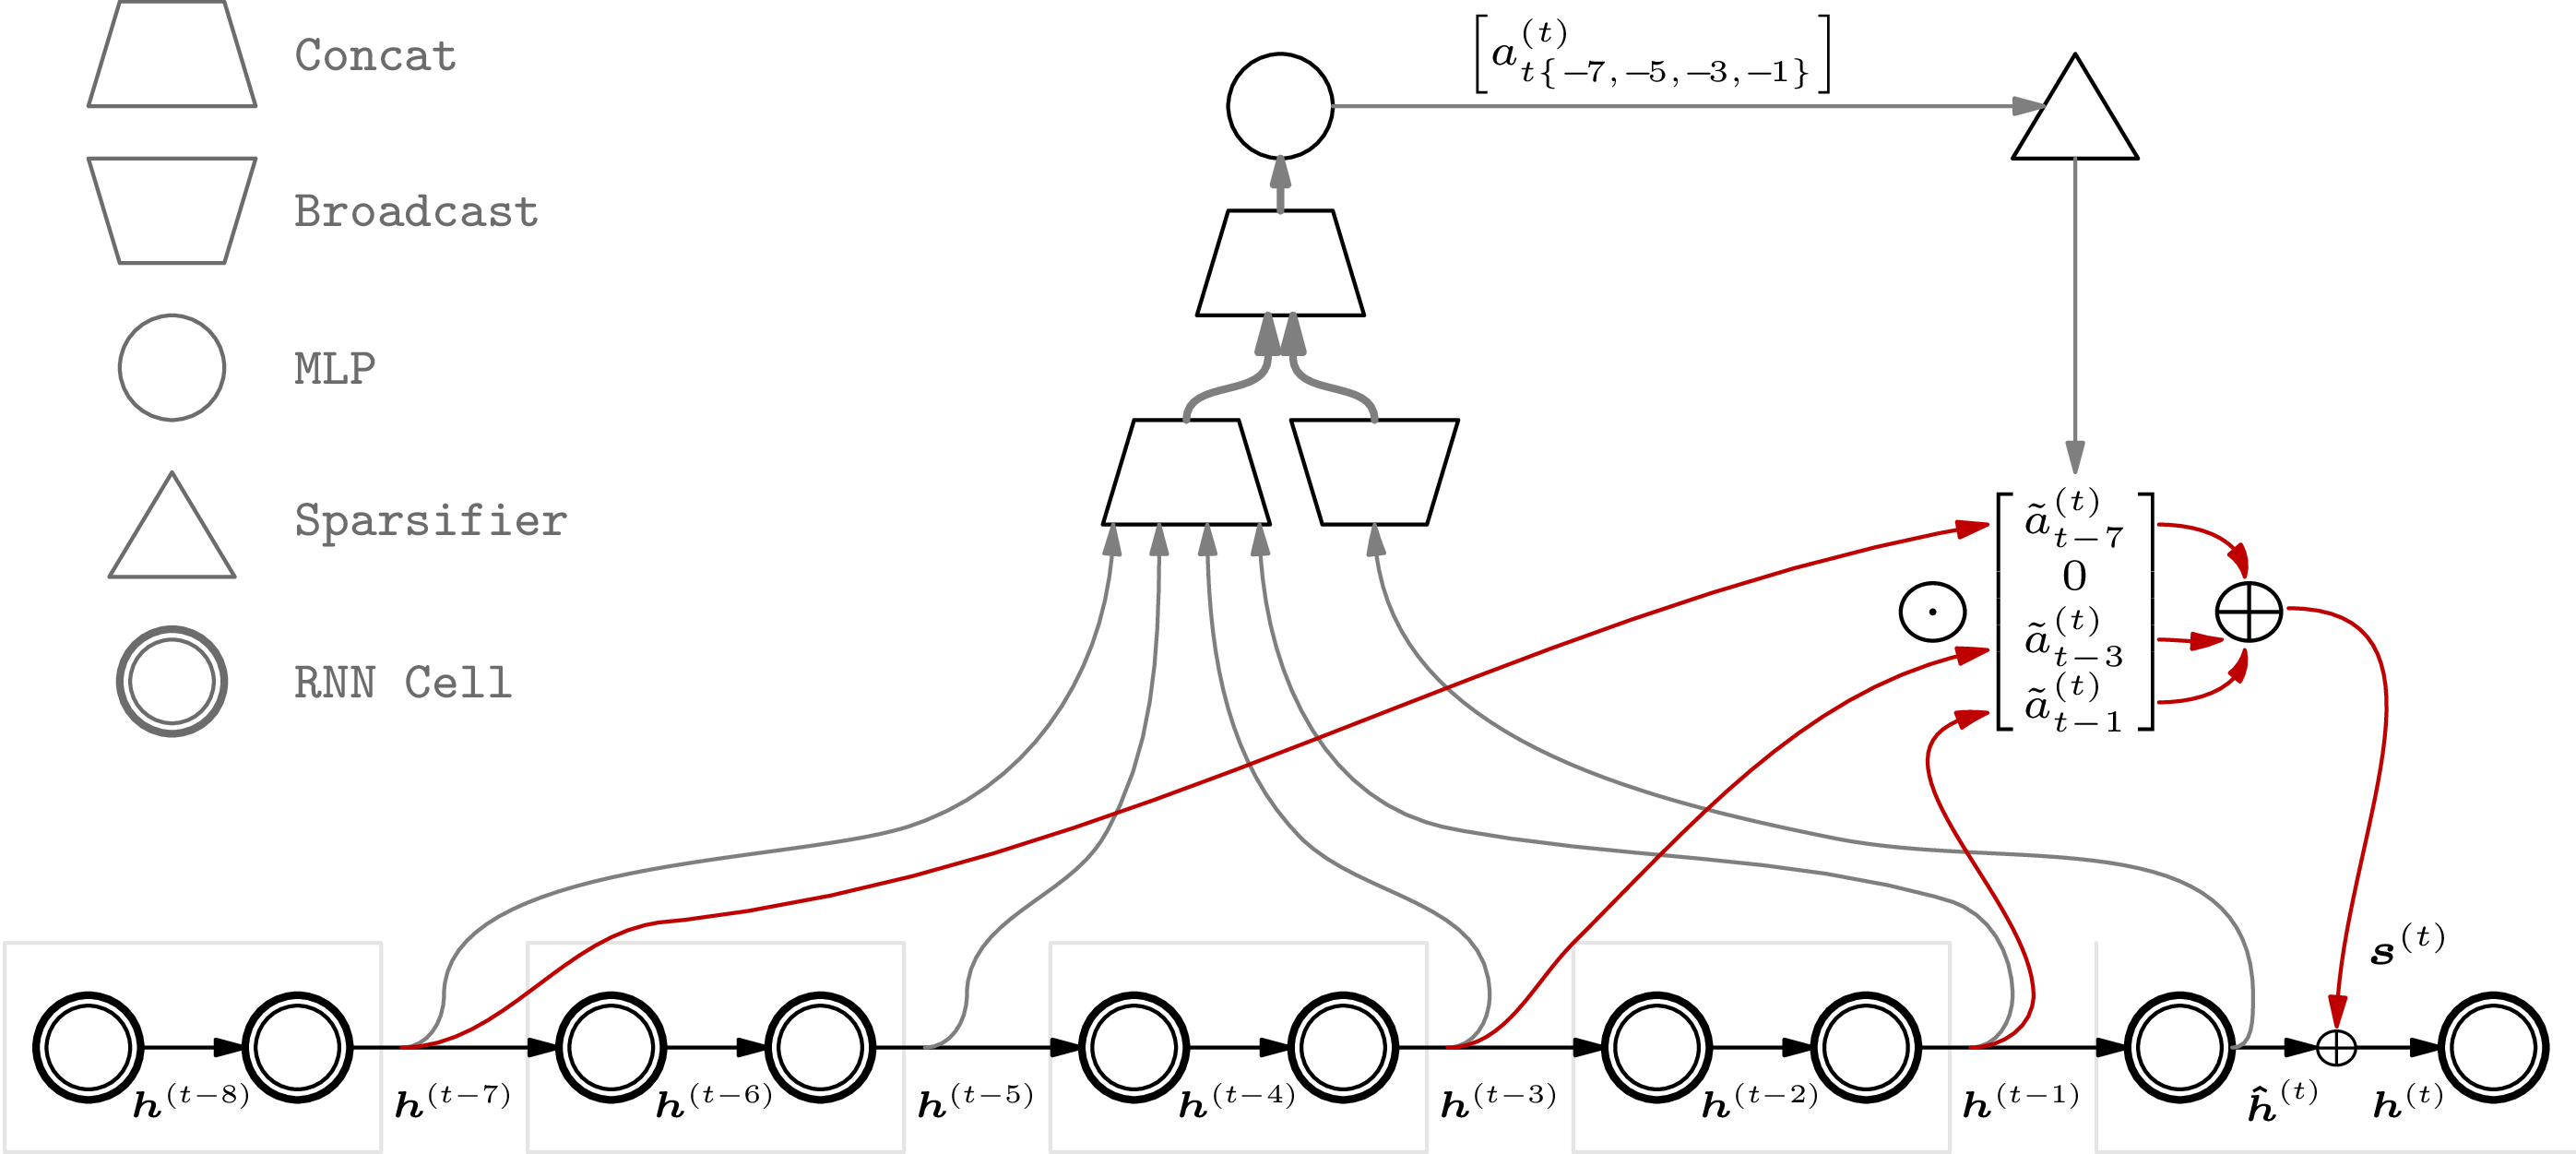
原图 1,PDF 第 4 页;使用作者原始图件。图中 $k_{\mathrm{top}}=3$、$k_{\mathrm{att}}=2$、$k_{\mathrm{trunc}}=2$。沿底部从左到右是时间推进;灰线表示对候选记忆打分,红线表示被保留记忆进入加权摘要,并加回当前临时状态。图例区分拼接、广播、MLP、稀疏化和 RNN 单元。摘要只用少量状态,但灰色打分路径仍覆盖全部候选。
2.5 反向:先跨时间跳跃,再回传局部历史
训练时,当前损失的梯度可沿两种路径传播:沿普通递归边向最近的状态回传;沿稀疏读取边到达被选中的远处记忆。到达记忆时,mental updates 进一步在该时刻之前展开长度为 $k_{\mathrm{trunc}}$ 的局部 TBPTT,从而训练产生记忆的局部计算。(第 3.2 节,PDF 第 5 页。)
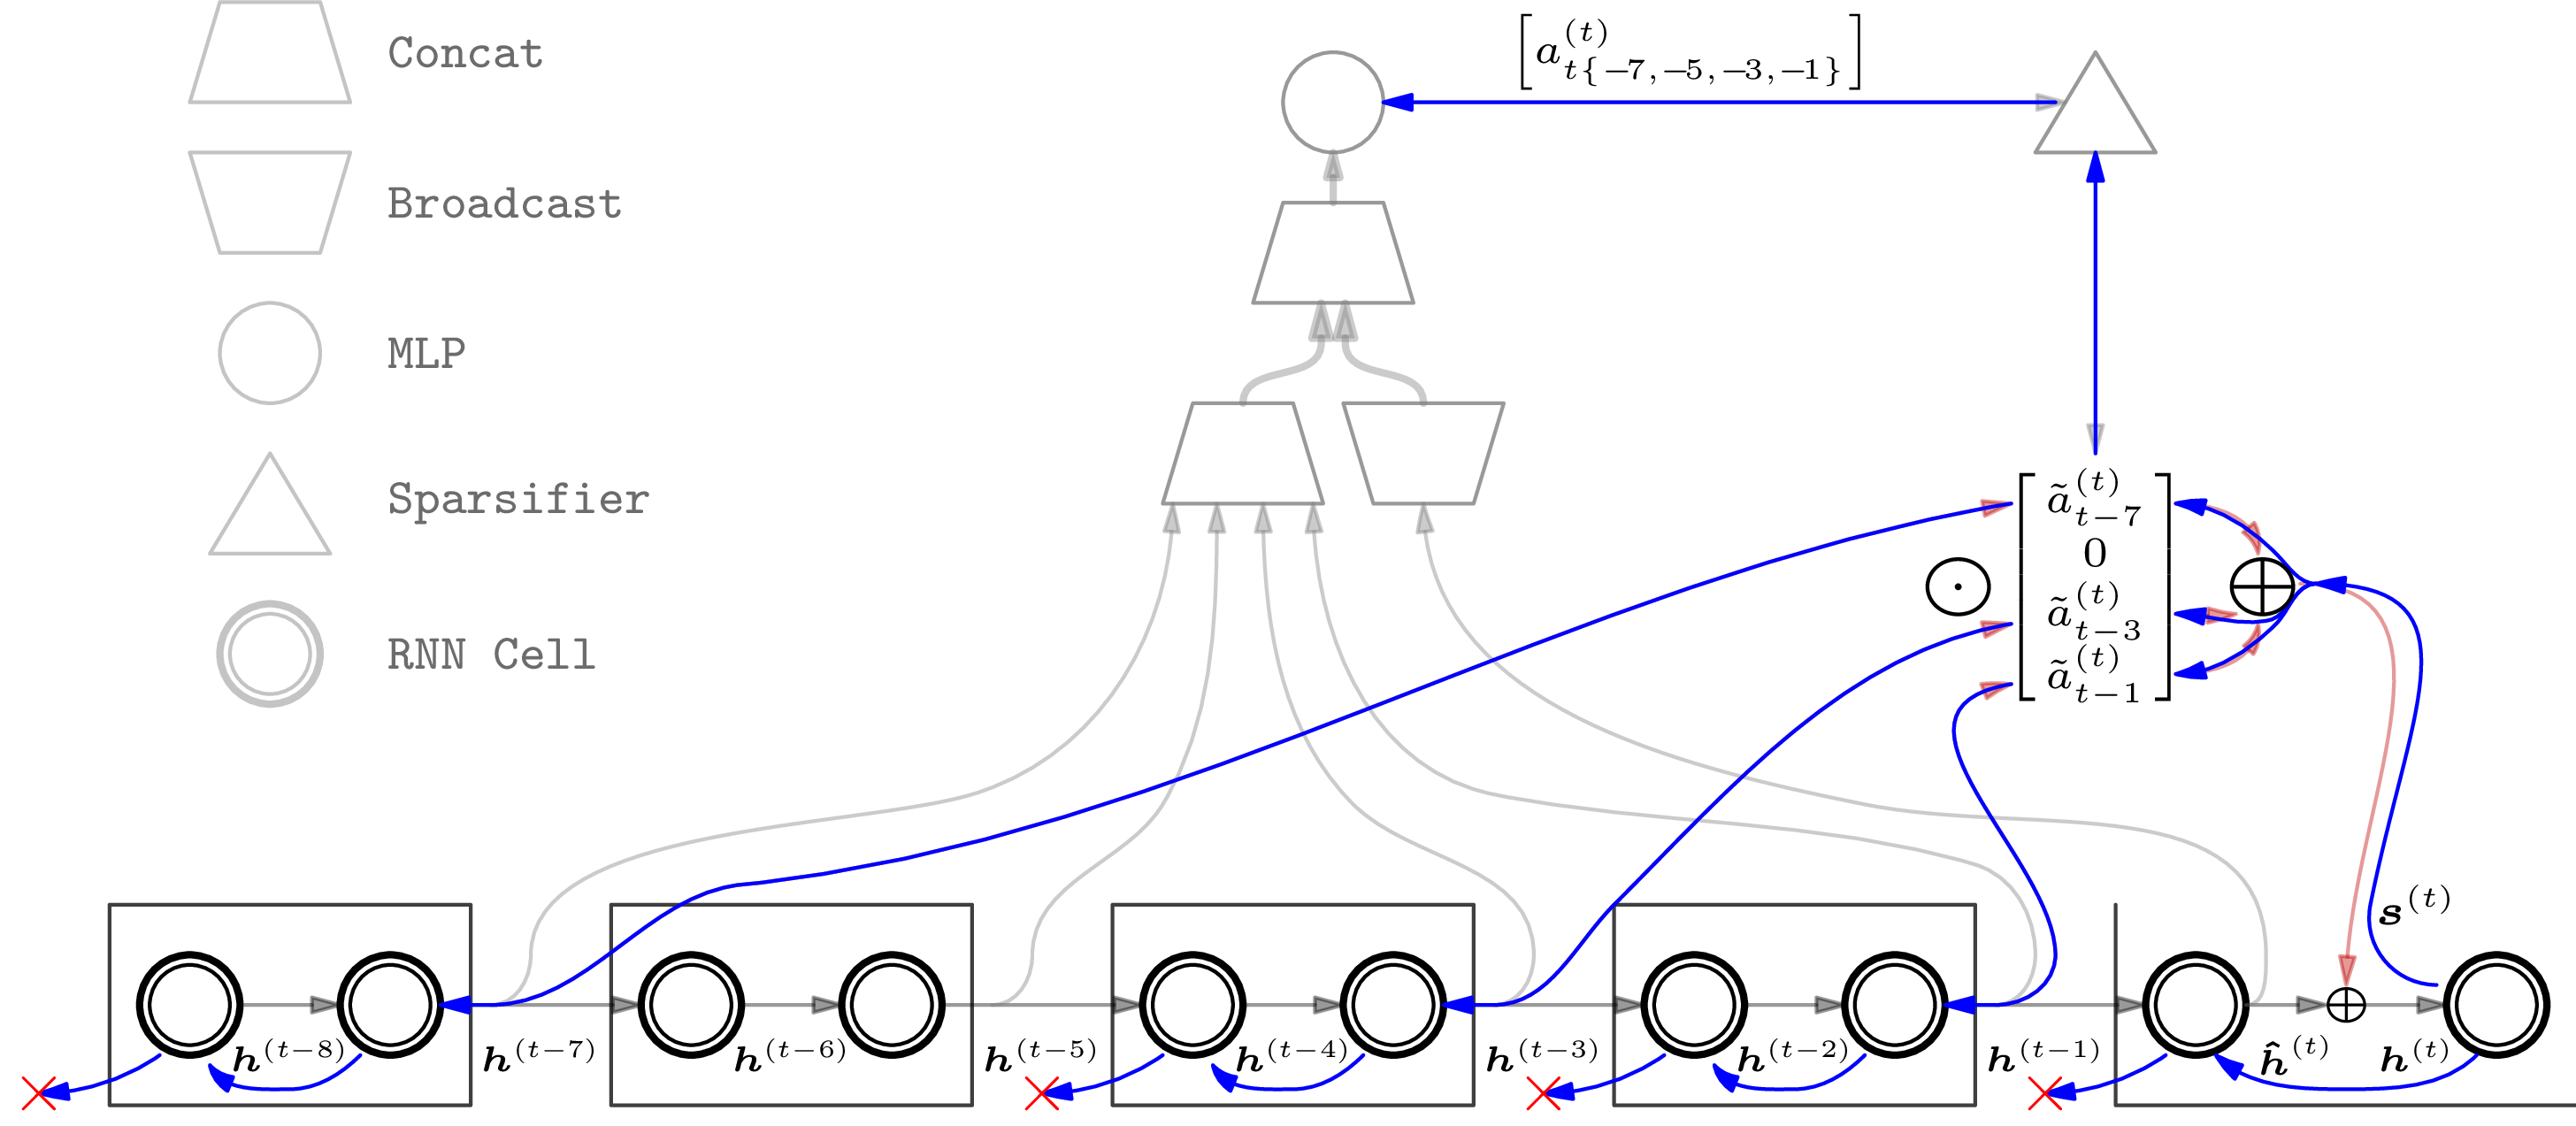
原图 2,PDF 第 6 页;使用作者原始图件。蓝色箭头是反向梯度,红叉是截断点。重点是蓝色长跳跃边如何连接到多个局部反传片段;未必要逐个经过两片段之间的所有时间步。
以下是对直接读取路径的教学推导。若暂时固定注意力权重及选中集合,则对被读记忆:
这条边不含跨越整个时间间隔的雅可比连乘,因而能缩短有效信用路径。完整导数还包含注意力分数和其他递归依赖;上式只用来解释跳跃边的作用。未被读取的记忆没有这条 value 直达路径,而记忆前方的短片段则依靠 mental updates 获得梯度。
SAB 仍然使用反向传播,并通过截断得到近似梯度。改变的是计算图中保留哪些信用路径;推理时只运行检索和状态更新,不执行 mental updates。由于旧记忆本身也可能依赖更旧的记忆,整体反向图还可能形成多级跳跃,不能简单把总反向开销写成 $k_{\mathrm{top}}k_{\mathrm{trunc}}$。(第 8–8.1 节,PDF 第 13 页。)
2.6 三种“稀疏”必须分开看
SAB 在读取支持集和局部回放上施加了预算;存储则采用固定周期采样,检索前的打分仍扫描全体记忆。因此,增加 $k_{\mathrm{att}}$ 会降低候选数量,增加 $k_{\mathrm{top}}$ 会扩大一次读取的范围,而增加 $k_{\mathrm{trunc}}$ 会扩大局部训练范围。三者作用不同,实验表中的配置应按完整组合比较。
三:实验——每组对照在检验什么
3.1 对照方法的角色
| 方法 | 前向历史访问 | 训练路径 | 比较意义 |
|---|---|---|---|
| LSTM + full BPTT | 通过循环状态传递 | 完整展开当前训练序列 | 不增加记忆检索的强基线 |
| LSTM + TBPTT | 同上 | 仅保留短顺序反传 | 检验截断引起的性能损失 |
| LSTM + full self-attention | 直接读取全部历史状态 | 完整 BPTT | 检验稀疏读出相对稠密读取的能力 |
| 稠密注意力 + 截断 | 全部历史候选 | 截断训练 | 区分稀疏性和“仅加 attention”的效果 |
| SAB 去除 mental updates | 仍可检索过去 | 不继续回传被读记忆之前的局部片段 | 检验局部信用分配的增益 |
| Transformer | 论文中的自注意力模型 | 相应训练设置 | 在两个序列图像任务上比较模型表现 |
主文的基线介绍是总体列表,具体结果以各表实际报告的行为准。尤其在语言建模中,“full BPTT”对应附录的有限训练片段:PTB 长度 100,Text8 长度 180,并非对整个语料流一次完整反传。(第 4 节、7.2–7.5 节,PDF 第 5、12 页。)
3.2 合成任务:延迟复制与标记求和
复制任务:输入开头是 10 个来自 1–8 的随机符号,随后经历由 $T$ 控制的空白延迟,收到分隔信号后输出初始 10 个符号。关键指标是最后 10 个符号上的准确率(越高越好)与 $\mathrm{CE}_{10}$(交叉熵,越低越好);全序列 CE 混入大量容易预测的空白,不能代替目标符号准确率。表中准确率是符号级准确率,不是整段 10 个符号全部正确的比例。
求和任务:长度 $T$ 的数值序列来自 $U[0,1]$,另有一个含两个 1 的二值掩码,两个标记分别位于序列前半段和后半段;模型输出被标记数值之和。这检验少量远处事件能否被选择并整合。
两类任务中的基线与 SAB 使用 128 个隐藏单元、Adam、学习率 $10^{-3}$;稠密 SAB 消融另外搜索 $10^{-3}$ 至 $10^{-5}$ 的学习率并报告最佳结果。(第 7.1 节,PDF 第 12 页。)
3.3 语言建模与图像序列
| 任务 | 输入与评价 | 影响理解的配置 |
|---|---|---|
| 字符级 PTB | 下一字符预测;测试 BPC 越低越好 | 1000 个隐藏单元;不重叠长度 100;batch 32;学习率 0.002;最多 100 epochs,验证集早停 |
| 字符级 Text8 | 下一字符预测;测试 BPC 越低越好 | 前 90M/随后 5M/最后 5M 字符用于训练/验证/测试;长度 180;batch 64;附录注明基线 1000 隐藏单元;SAB 最多 30 epochs |
| pMNIST | 固定随机置换后的逐像素输入,最后预测类别;准确率越高越好 | LSTM 系列使用 128 隐藏单元;学习率 0.001;约 100 epochs,验证集早停 |
| 逐像素 CIFAR10 | 不置换,序列长度 1024,最后分类;准确率越高越好 | SAB 表中配置为 $(k_{\mathrm{trunc}},k_{\mathrm{top}},k_{\mathrm{att}})=(16,10,16)$ |
BPC 即平均每字符负对数概率,以 2 为底,单位为 bit/character。若测试字符数为 $N$,可写为 $-N^{-1}\sum_t\log_2 p(x_t\mid x_{ 以下从原表 1 选择准确率列;不同 $T$ 的模型分别在对应长度上训练。除特殊说明外,SAB 含 mental updates。 来源:表 1,PDF 第 7 页;“—”表示该单元格未报告。 在 $T=300$ 上,SAB $(5,5)$ 相对普通 LSTM full BPTT 提高 64.0 个百分点,相对 TBPTT-20 提高 74.2 个百分点,并接近稠密自注意力基线。这个结果支持“用少量直接历史读取替代漫长的逐步信息传递”。同时,$(1,1)$ 只有 43.1%,说明连接预算和局部回传范围仍然影响容量,不能将一个强配置的结果推广到所有稀疏程度。 表 1 个别 CE 单元格与对应准确率或其他 CE 列的关系显得异常,例如 LSTM 在 $T=300$ 的 $\mathrm{CE}_{10}=0.197$ 配合 35.9% 准确率;因此这里以准确率列和主要配置比较为依据,不用这些异常值推导损失降幅。 来源:表 2 左侧,PDF 第 7 页。原文将该指标标为 CE / cross-entropy,但第 7.1 节定义的是连续值求和,没有说明相应的概率输出或离散化方式。因此这里保留“原表损失”的叫法和原数值,不擅自改称 MSE,也不对其物理单位作解释。 $T=400$ 时 SAB 优于所列 TBPTT,但完整 BPTT 的损失更低。在这个受控任务里,直接回到两个相关事件已经非常有效;完整梯度仍可能提供更精细的学习信号。不同列中的最佳基线也不同:$T=200$ 是稠密 attention,$T=400$ 是普通 LSTM full BPTT。 来源:表 2 右侧,PDF 第 7 页。 PTB 上,SAB $(20,10,20)$ 的 1.37 BPC 接近 full BPTT 的 1.36,并优于相同局部截断长度的 TBPTT-20(1.40)。Text8 上,最好的表列 SAB 为 1.44,优于 TBPTT-5 的 1.56,但仍高于 full BPTT 的 1.42。这里比较的是各自列出的配置,SAB 与 TBPTT-5 的局部截断长度并不相同。 原文的两处不一致会改变结论,应就地保留: 来源:表 4,PDF 第 8 页;SAB 配置按 $(k_{\mathrm{trunc}},k_{\mathrm{top}},k_{\mathrm{att}})$ 排列。 pMNIST 上,最好的 SAB 比 LSTM full BPTT 高 3.9 个百分点,但比 Transformer 低 3.7 个百分点。CIFAR10 上,SAB 比 LSTM full BPTT 高 6.2 个百分点,比 Transformer 高 2.3 个百分点。因此,摘要式的“胜过 Transformer”应限定为本文的逐像素 CIFAR10 结果。论文没有充分展开 Transformer 的配置与参数预算,适合将它视作所报设置下的任务比较。 所有模型先在复制任务 $T=100$ 上训练到收敛,再直接评估更大的 $T$。 来源:表 5,PDF 第 8 页。指标为最后 10 个符号的准确率;8 类符号随机猜测为 12.5%。OOM 表示原实验内存不足,不是准确率为零。 根据原表 5 重绘,PDF 第 8 页。横轴是测试延迟 $T$(对数刻度),纵轴是准确率;稠密自注意力曲线在 $T=2000$ 后停止,未将 $T=5000$ 的 OOM 画成数值。图中虚线表示随机猜测。 在 50 倍训练延迟下,SAB 仍比随机猜测高 28.5 个百分点。合理的机制解释是,相关事件可被直接访问,增加中间空白不必同比拉长主要信用路径;这与该任务的稀疏相关事件结构一致。SAB 本身也从 99% 降至 41%,所以原文“仍能完成任务”的说法应理解为保有明显有效的记忆能力,而非可靠复现每一段序列。该表也未提供 SAB 的完整超参数,不能把主文某个 $(5,5)$ 配置直接套到这里。 mental updates 的贡献:用原表 1 与表 3 中对应的 $T=100$ 配置比较。 来源:表 1、表 3,PDF 第 7–8 页。直接读取较多历史状态时,复制任务即使没有 MU 也已接近饱和;最小预算下 MU 的增益更明显。求和消融中,无 MU 的 $(10,10)$ 损失为 $2.171\times10^{-6}$,有 MU 为 $2.0\times10^{-6}$,差距很小。消融支持局部回放的价值,也表明其必要程度随任务和读取预算变化。 稀疏性的贡献:$k_{\mathrm{trunc}}=5$ 时,读出全部历史的稠密消融准确率只有 40.5%,而 SAB $(5,5)$ 为 100.0%。附录注明作者为更难训练的稠密版本额外搜索了学习率。这个差异说明在该截断训练设置中,“多读一些”不自动带来更好的学习;稀疏预算可能把信用集中到少量相关节点。(表 3、7.1 节,PDF 第 8、12 页。) 原表 3 右侧图,PDF 第 8 页;使用作者矢量图转出的 PNG。横轴是历史记忆位置,越靠左越早;纵轴是复制输出阶段的时间步;黑色代表更高注意力。面板 a、b、c 是第一轮训练内的不同时刻,从上到下可见注意力转向序列开头最初 10 个相关状态。它为“学会找回有用事件”的解释提供了直观支持。 原文第 8 节以 $t$ 表示序列长度、$n$ 表示隐藏维度,在不限制记忆增长的设置下给出: 一个解释这一量级的教学估算是:第 $s$ 步约有 $s/k_{\mathrm{att}}$ 条候选,若按论文的未缓存稠密 MLP 计算方式、打分隐藏宽度与 $n$ 同阶,则候选打分累计约为 $\sum_{s=1}^t O(sn^2/k_{\mathrm{att}})=O(t^2n^2/k_{\mathrm{att}})$。固定 $k_{\mathrm{att}}$ 后即为原文量级;被选摘要的加权求和才只涉及 $k_{\mathrm{top}}$ 个值。 反向路径虽然局部稀疏,传回一条记忆后还可能触及它之前的其他记忆。原文指出,最坏情况下可能多次触及全部过去状态。因此,本文适合支持“短局部更新能够学长依赖”,不提供端到端训练加速倍数或有界资源保证。(第 8 节,PDF 第 13 页。) 第 8.1 节还报告梯度裁剪观察:Text8 仍需要裁剪,而所测 PTB、逐像素 MNIST 中有无裁剪差别很小。这说明缩短梯度路径有助于稳定性,但没有消除所有数值问题。 把记忆读取视为信用路由。 检索模块既决定当前能看到什么,也决定哪些旧计算会得到训练。设计记忆系统时,仅检查推理时的读取能力可能不足,还应检查梯度能否抵达写入过程。 远距离与长局部反传可以解耦。 有用记忆可以很远,但生成它的局部计算片段很短。复制任务和稀疏相关事件的求和任务很好地体现了这一结构。 内容选择比周期采样更值得进一步研究。 本文按固定 $k_{\mathrm{att}}$ 写入,不能主动保护罕见、突发或重要事件;作者在结论中提出按显著性、意外程度选择记忆,并给检索加入更强的相似性归纳偏置。若要面向持续增长的序列,还需要把有界记忆管理与高效候选检索纳入同一个设计,而这两部分在本文中尚未解决。(第 5 节,PDF 第 8 页。) 对这篇工作的恰当定位是:SAB 用实验说明,选择少量过去状态,并围绕它们回传局部梯度,可以弥补纯 TBPTT 的远程信用缺口,并带来显著的复制长度外推收益。语言建模主要体现对截断损失的恢复;图像序列比较则体现任务依赖的优势。四:结果——长程信用路径有效,但收益因任务而异
4.1 复制:短局部回传可以跨越长延迟
模型 / 配置 $T=100$ 准确率 % ↑ $T=200$ 准确率 % ↑ $T=300$ 准确率 % ↑ LSTM + full BPTT 99.8 56.0 35.9 LSTM + full self-attention + full BPTT 100.0 100.0 100.0 LSTM + TBPTT,$k_{\mathrm{trunc}}=20$ 30.5 35.8 25.7 SAB,$(k_{\mathrm{trunc}},k_{\mathrm{top}})=(1,1)$ 57.9 39.9 43.1 SAB,$(1,5)$ 100.0 — 89.1 SAB,$(5,5)$ 100.0 100.0 99.9 4.2 求和:明显好于截断基线,较长序列上仍落后完整反传
模型 / 配置 $T=200$ 原表损失 ↓ $T=400$ 原表损失 ↓ LSTM + full BPTT $4.59\times10^{-6}$ $1.554\times10^{-7}$ LSTM + full self-attention + full BPTT $5.541\times10^{-8}$ $4.972\times10^{-7}$ LSTM + TBPTT $3.0\times10^{-4}$(截断 50) $6.8\times10^{-4}$(截断 100) SAB,$(k_{\mathrm{trunc}},k_{\mathrm{top}})=(10,10)$ $2.0\times10^{-6}$ $1.001\times10^{-5}$ 4.3 PTB / Text8:主要收益是追回截断损失
模型 $(k_{\mathrm{trunc}},k_{\mathrm{top}},k_{\mathrm{att}})$ PTB BPC ↓ Text8 BPC ↓ LSTM + full BPTT full 1.36 1.42 LSTM + TBPTT $(5,-,-)$ 1.44 1.56 LSTM + TBPTT $(20,-,-)$ 1.40 — SAB $(10,5,10)$ 1.42 1.47 SAB $(10,10,10)$ 1.40 1.45 SAB $(20,5,20)$ 1.39 1.45 SAB $(20,10,20)$ 1.37 1.44 4.4 序列图像:SAB 与 Transformer 各有胜负
模型 / SAB 配置 pMNIST 准确率 % ↑ 逐像素 CIFAR10 准确率 % ↑ LSTM + full BPTT 90.3 58.3 LSTM + TBPTT-300 — 51.3 SAB $(20,5,20)$ 89.8 — SAB $(20,10,20)$ 90.9 — SAB $(50,10,50)$ 94.2 — SAB $(16,10,16)$ — 64.5 Transformer 97.9 62.2 4.5 长度迁移:外推优势很大,准确率仍随长度下降
测试延迟 $T$ LSTM % ↑ LSTM + full self-attention % ↑ SAB % ↑ 100 99 100 99 200 34 52 95 300 25 28 83 400 21 20 75 2000 12 12 47 5000 12 OOM 41 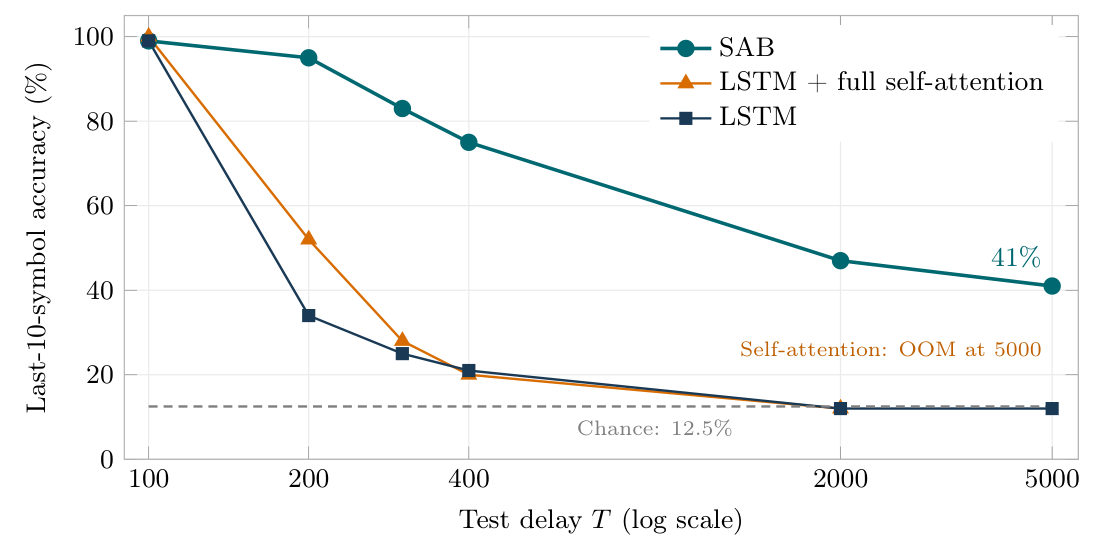
4.6 消融:读取几条记忆以及怎样训练它们都重要
$(k_{\mathrm{trunc}},k_{\mathrm{top}})$ 有 MU:准确率 % ↑ 无 MU:准确率 % ↑ 差值(百分点) $(1,1)$ 57.9 49.0 +8.9 $(5,5)$ 100.0 98.3 +1.7 $(10,10)$ 100.0 99.6 +0.4 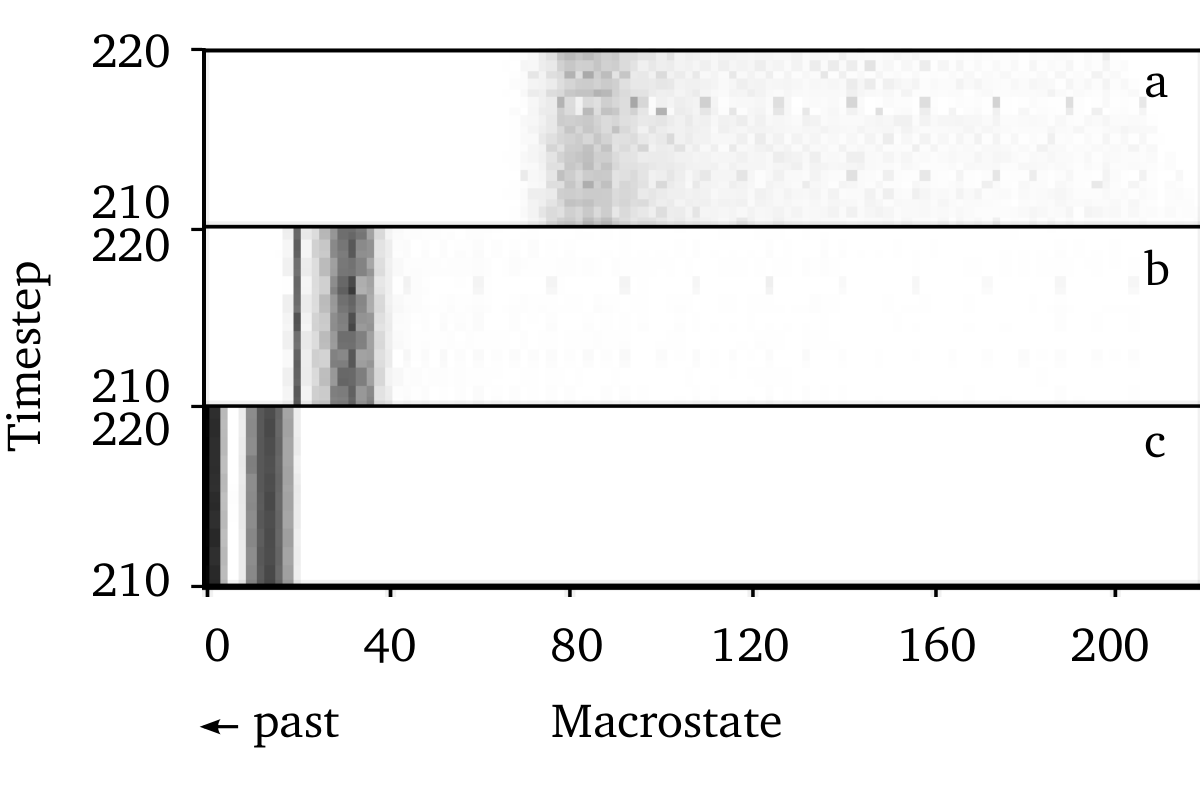
五:结论——贡献在信用路径设计,取舍在检索与记忆
5.1 计算开销决定了如何理解“稀疏”
项目 原文复杂度 对使用方式的含义 整段序列前向时间,训练与推理 $O(t^2n^2)$ 每步仍对越来越多的历史候选做 MLP 打分 训练前向状态空间 $O(tn)$ 原文给出的状态存储量级与完整历史同阶 推理记忆空间 $O(tn)$ 从普通 LSTM 的 $O(n)$ 上升为随历史增长 反向时间 未给统一紧界 旧记忆可依赖更旧记忆,形成递归的有向无环图 5.2 值得保留的方法启发
配套材料