# Language Models Can Control Their Own Attention:中文研读笔记
- **方法**:声明式注意力(Declarative Attention,DA)。
- **作者**:Namgyu Ho、Huzama Ahmad、Woosung Koh、Se-Young Yun、Tal Schuster、Cicero Nogueira dos Santos;机构为 KAIST AI、Google DeepMind。
- **版本**:[arXiv:2609.02737v1](https://arxiv.org/abs/2609.02737v1),2026-09-02 提交;获取及研读日期:2026-09-18。
- **材料**:[原文 PDF](../source/paper.pdf)、同版本作者 TeX `paper.tex`、实际引用的五个提示词文件及宏定义、原始图件;PDF 共 42 页。已阅读正文 §1–8、附录 A–F,并核对关键图表与最终 PDF。参考文献用于理解本文定位,未逐篇阅读其引用论文,也未独立复现实验。以下页码均指从 1 开始的 PDF 页码。
## 论文总览
**核心问题**:长上下文模型每生成一个 token,全局注意力层都需要读取大量 KV 缓存。即便最终注意力只集中于很少的信息,确定这些信息本身通常仍需扫描上下文。能否让模型直接在输出里声明“接下来我要看哪一段”,从而让推理引擎跳过其余读取?
DA 用同一个零样本协议让现成模型在 `global`、`focus`、`local` 三种模式间切换,引擎将声明变成可逆的 KV 块可见性控制。大模型上的实验说明这件事可以做到,但不是无损稀疏化:在选定的 15 个任务源上,Gemma-4-31B 的平均准确率从 87.01% 降到 85.74%,总 attended tokens 从 13.43M 降到 6.45M;Qwen-3.6-27B 对应为 85.31%→82.56%、22.54M→15.52M。
**最重要的阅读边界**:52.0%/31.1% 是解码期间累计注意力位置数的减少,不能直接称为延迟下降、显存容量下降或吞吐提升。论文报告的 0.71×/0.77× 解码时间是指定利用率下的 roofline 估算,未报告与之对应的端到端实测加速。失败案例和小模型结果也限制了“通用有效”的表述。
## 结构地图
| 原文章节 | 论证作用 | PDF 页码与关键证据 |
|---|---|---|
| 1 Introduction | 每步扫描的代价;用文本声明选区 | 2–3 |
| 2 Declarative Attention;2.1 Prompt overview;2.2 Context delivery;2.3 Decode-time interventions | 三模式、分段、状态机与块表 | 3–5;图 1 在第 1 页 |
| 3 When does DA pay off? | 大批量、长上下文下的成本模型 | 5–6 |
| 4 Experimental settings | 模型、任务、对照、指标 | 6–7;表 1 在第 6 页 |
| 5 Results;5.1 Main results;5.2 Model capability scaling;5.3 Context-length scaling;5.4 Efficiency results | 主效果与三个尺度/效率问题 | 7–11;表 2–3、图 2–4 |
| 6 Analysis;6.1 Efficiency impact of DA modes;6.2 Protocol adherence | 模式分布与协议遵循 | 11–12;图 5–6 |
| 7 Conclusion | 研究结论 | 12 |
| 8 Discussion, Limitations, and Future Work | 训练、agent、稀疏注意力协作的潜力 | 13–14 |
| A Related works | 与扫描、驱逐、自声明注意力的关系 | 23–25 |
| B DA vLLM integration | 常驻区、后端、块对齐 | 25 |
| C Background on inference costs and derivation of roofline wall-time | 成本公式、架构常数和外推 | 25–32;表 4–8 |
| D Experimental details | 评估器、采样、失败任务 | 32–35;图 7、表 9–10 |
| E Additional experimental results | Qwen 长上下文结果及归一化成本 | 34–36;图 8–10 |
| F Prompt construction | 切段算法和完整提示词 | 37–42 |
## 一:动机
### 1.1 为什么低注意力权重不自动意味着低成本
注意力权重是在读取 key、计算相关性之后才得到的。观察到“大多数 token 的权重很小”,并不能让运行时在读取之前知道该跳过谁。已有方法可基于历史统计永久移除缓存,也可用较便宜的索引器扫描代理表示,但后者一般仍有随上下文长度 $N$ 增长的每步选择成本。DA 把选区变成模型输出的一部分,在一个模式持续的区间里复用范围,不再为每个 focus/local 步骤额外扫描完整代理缓存。(§1,PDF 2–3;附录 A,PDF 23–25)
这里的“免除选择扫描”不是整段推理免费检索:global 模式仍需完整注意力,而且产生声明、抽取证据会增加解码步骤。收益来自“昂贵的查找阶段”和“较便宜的抽取/计算阶段”之间的分工。
### 1.2 创新应如何定位
作者没有首次提出“模型选择自己的注意力范围”。附录 A.5 明确讨论 Self-Selected Attention Span:此前用特定任务训练、手工设计分区和语法,在较短上下文中实现过这一思路。本文的具体贡献是:一个固定的、任务无关的零样本协议,在两类现成模型及长上下文任务上运行,并通过推理引擎的块表修改实际减少读取。
DA 与检索、压缩和驱逐分别控制不同对象:检索决定哪些材料进入上下文;DA 控制已经驻留的上下文在当前步骤是否被读取;驱逐/压缩则会改变存储内容或序列。本文 **保留完整 KV 缓存**,所以可以恢复 global,代价是没有直接减少缓存驻留容量。
## 二:方法
### 2.1 输入、处理和输出
输入包括固定系统提示、切段后的长材料、问题与 DA 指令。切段目标为 2,048 tokens,上限通常为 2,560;优先沿段落、换行、句末、子句、词边界拆分。作者在字符偏移空间生成真实子串,拼接后可还原全文;无空白的超长片段作为不可拆单位,允许超出上限。(§2.2;附录 F,PDF 37)
每段叫作 **magic chunk**,通过预构造的工具对话呈现:assistant 调用 `get_magic_chunk`,tool 返回编号和文本。这只是输入格式,生成前全部材料已在上下文中,并没有真实执行检索工具。使用熟悉的消息边界是为了帮助模型追踪段落位置;“magic chunk”也避免其将分段编号误当成文档章节号。
随后模型生成带标签的回答;状态机解析标签并改变全局注意力层可读的块列表;最终答案按 `...` 输出。无模型参数更新,但需要修改推理运行时,单靠在普通聊天界面粘贴提示词不会实现物理读取节省。
### 2.2 三模式究竟看得到什么
| 模式 | 能读取的长材料 | 仍然可见的信息 | 提示词建议用途 |
|---|---|---|---|
| `global` | 全部 chunks | 常驻区与已生成回答 | 找出下一段证据在哪里 |
| `focus` | 标签点名的一段或多段 | 常驻区与已生成回答 | 抽取原文值、日期或短语 |
| `local` | 不读取任何 chunk | 常驻区与已生成回答 | 规划、计算、汇总证据 |
“常驻区”实现为开头 16-token attention sink(短系统提示占据)、覆盖问题和 DA 指令的末端提示区,以及整个已生成回答。**local 不是只保留最后几个输出 token,也不是把模型已有隐藏状态的信息抹掉。** 它只限定当前全局注意力层对原始 chunk 的读取;SWA/GDN 层保持原样。因此可以说“不能直接重读这些 chunk”,不能将它理解为严格的信息隔离证明。(附录 B,PDF 25;后半句为本次分析)
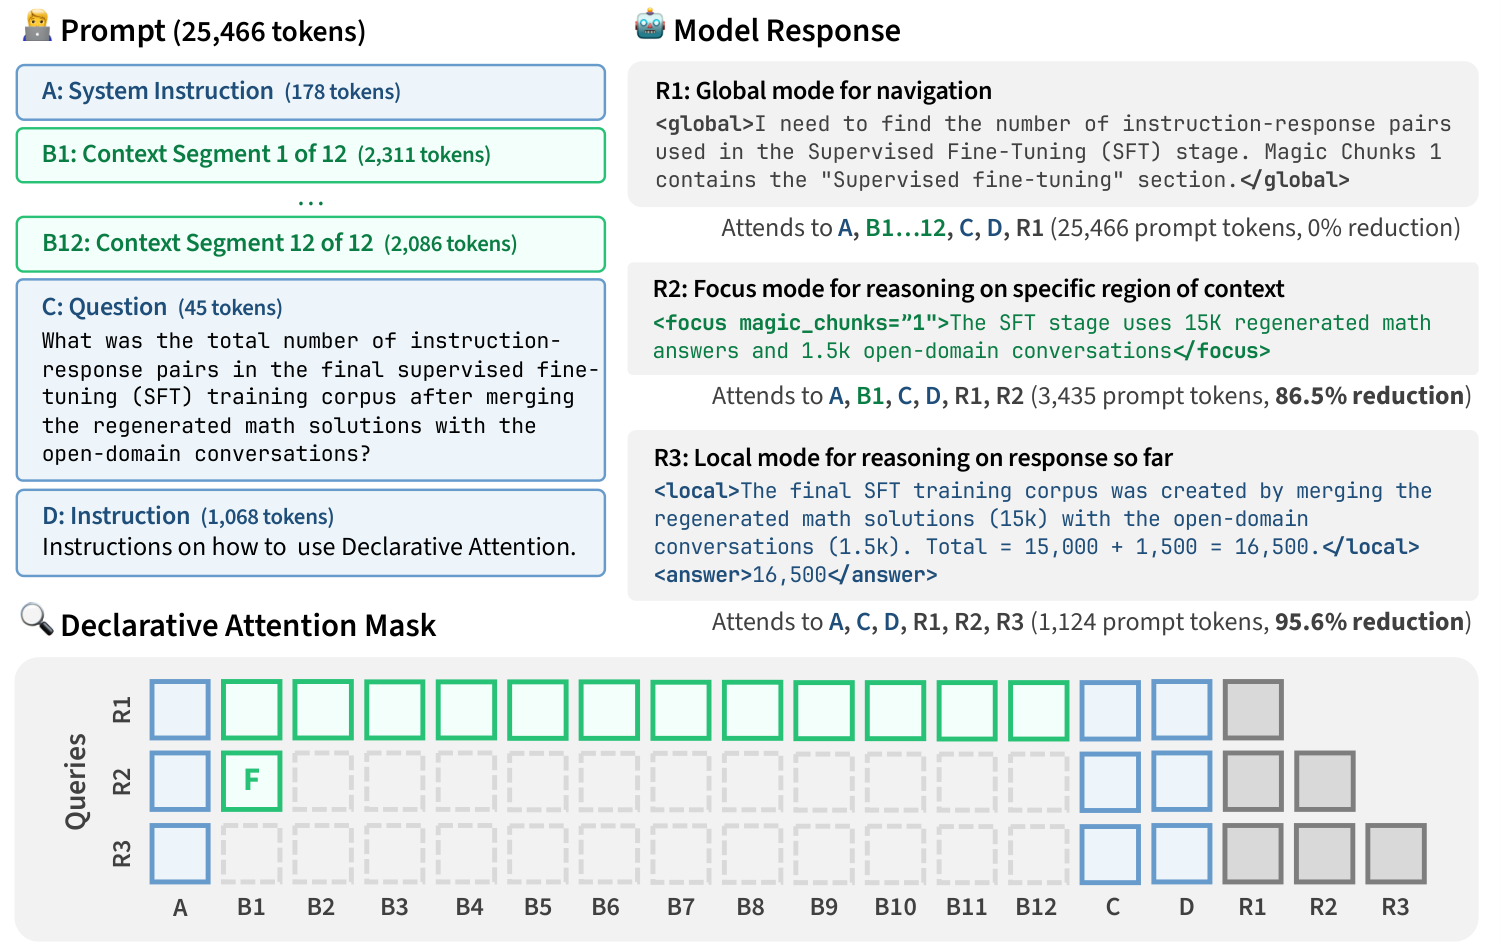
图 1(PDF 1),原始作者图。先看左侧输入:蓝色是常驻 scaffold,绿色是可选择的材料;再看右侧导航、抽取、汇总三个输出区间;最后看下方掩码:横轴是输入/响应片段,纵轴是三个推理区间,虚线格被遮蔽。该图展示机制,不是总体实验均值;图中 86.5%/95.6% 只是示例中提示位置数的减少。
### 2.3 状态机与系统实现
默认状态是 global。解析完整的 `` 或 `` 开标签后,在结束字符 `>` 触发切换;对应闭标签恢复 global。显式 `` 主要组织文本,默认状态已是 global。`focus` 可以声明多个 chunk;协议没有硬性固定顺序或次数,提示词仅软性要求至少使用一次 focus、最后有 local 做答案确认。
运行时把保留跨度向外对齐到 KV cache 的块边界,典型块大小 $b$ 为 16–32 tokens。每个跨度每侧最多多保留 $b-1$ 个位置,以免误删声明范围内的 token。然后通过 vLLM attention metadata builder 的 hook 改写请求的 KV 块表,现有内核读更少的块,不改内核或调度器。Qwen 的全局层走 FlashAttention,Gemma 的混合结构使用 Triton paged-attention 后端。(§2.3,PDF 4–5;附录 B,PDF 25)
掩码只作用于 **全局注意力层**。Qwen 的 Gated DeltaNet(GDN)递归状态、Gemma 的 1,024-token sliding window attention(SWA)仍有固定成本。标签外的最终答案也不能被一概视为 local:按默认状态规则,local 闭标签后已恢复 global,除非另有模式声明。
### 2.4 一个教学例子
问题是“公司成立到上市间隔几年”。先在 global 定位第 2 段,从 focus 抽取“2003”;再回到 global 定位第 7 段,从 focus 抽取“2011”;最后在 local 中计算 $2011-2003=8$。两个年份已写进回答,所以算术阶段无需重读完整材料。这是对 §2 示例的教学解释,不是额外实验。
### 2.5 成本模型与适用假设
作者的关键观测量是每条回答的累计注意力位置数:
$$A=\sum_{t=1}^{D}\operatorname{attended}(t).$$
$D$ 是解码步数,$\operatorname{attended}(t)$ 是第 $t$ 步可见的 KV token 位置数;单位是“位置×步”,不是输入长度、输出长度或真实 HBM 测量字节数。总量按源内平均后对 15 个源等权平均。比较时使用平均总量之比,不能将其换成逐任务百分比的简单均值。(§4,PDF 7)
将附录 C.8 的三项写在一起,可得到下式(原文逐项给出,以下为合并表达,无原公式编号):
$$T_{\mathrm{decode}}\approx
\frac{2PD}{C_{\mathrm{peak}}u_{\mathrm{FLOPs}}}
+\frac{A b_{\mathrm{kv}}}{B_{\mathrm{peak}}u_{\mathrm{BW}}}
+\frac{D s_{\mathrm{local}}}{B_{\mathrm{peak}}u_{\mathrm{BW}}}.$$
| 符号 | 含义/单位 |
|---|---|
| $P$ | 活跃参数数目;每步矩阵乘工作量近似 $2P$ FLOPs |
| $C_{\mathrm{peak}}$、$u_{\mathrm{FLOPs}}$ | 峰值算力(FLOPs/s)与 MFU |
| $B_{\mathrm{peak}}$、$u_{\mathrm{BW}}$ | 峰值带宽(bytes/s)与 MBU |
| $b_{\mathrm{kv}}$ | 所有全局层每个 KV 位置的字节数 |
| $s_{\mathrm{local}}$ | 每步 SWA/GDN 固定读取字节数 |
bf16 下,$b_{\mathrm{kv}}=2L_{\mathrm{global}}n_{\mathrm{kv}}d_{\mathrm{head}}\times2$ bytes;第一个 2 表示 K 和 V,最后一个 2 表示每元素字节数。Gemma 的 $b_{\mathrm{kv}}=81,920$ B、$s_{\mathrm{local}}=838.9$ MB;Qwen 对应 65,536 B、78.45 MB。(表 4,PDF 28)
DA 降低 $A$,但通常增大 $D$。成立条件是全局读取节省超过矩阵计算和固定状态读取的额外成本。这里假定足够大的批量令权重读取得到摊薄、矩阵乘以计算为瓶颈,注意力以带宽为瓶颈。低并发、短上下文、prefill 主导的系统不能直接套用此结果。
**教学近似**:若忽略模板和响应长度差异,global 比例为 $g$、focus/local 平均读取比例为 $q$、解码步数膨胀倍数为 $r$,则 $A_{DA}/A_V\approx r[g+(1-g)q]$。此式用于直觉,不是作者拟合模型:局部读取再省,也会被 global 比例和生成冗长抵消。
## 三:实验
### 3.1 实验问题与设置
主比较使用 Gemma-4-31B、Qwen-3.6-27B;模型规模实验另含 Gemma-4-12B、Gemma-4-E4B、Qwen-3.5-9B、Qwen-3.5-4B。每个模型先过滤超长样本,再固定种子从每个源抽取至多 128 条;同模型三种方法使用相同样本。不同模型因 tokenizer 或上下文上限,实际样本可能不同。
通常过滤阈值为 244K(256K 输入预算减 8K 生成和 4K 模板预留),E4B 为 116K。表 1 的百万 token 代码源统计是**源数据长度分布**,不代表主实验测试了百万 token 输入。附录 C 的 1M 场景是成本外推。
所有被测模型关闭原生 thinking mode,因为预实验发现在 thinking 标签中不能遵循 DA。关闭原生 thinking 不等于没有文本推理,提示词仍要求在普通输出中分步作答。最大生成长度 8K;B200 GPU、vLLM。Qwen temperature=0.7、top-p=0.80、top-k=20、presence penalty=1.5;Gemma temperature=1.0、top-p=0.95、top-k=64。(§4,PDF 6–7;附录 D.3,PDF 33)
### 3.2 数据源与任务口径
| 分组 | 任务源 | QA 来源与作用 |
|---|---|---|
| 单跨度检索/推理(10 源) | RULER niah_single_1/2/3、niah_multikey_2/3 | 原始 QA;口令、UUID、行与键值检索 |
| 同上 | LBv1 qmsum、LBv2 multidoc_qa、LooGLE summarization | 合成 QA;会议、多文档、科研文章材料 |
| 同上 | LBv2 code_repo、ZS quality | 原始 QA;代码仓库与故事选择题 |
| 多跨度推理(5 源) | LBv2 singledoc_qa | 合成 QA;需要组合材料 |
| 同上 | LBv2 dialogue_history、LooGLE longdep_qa/shortdep_cloze、ZS space_digest | 原始 QA;对话、长依赖、填空、情感问题 |
11 个源使用原始 QA;4 个由 Gemini-3-Flash 生成 QA。尤其 LooGLE `summarization` 在此被改成 QA,不能将其结果读作原始长摘要任务上的性能。主表不是所有长上下文任务的全面抽样;附录还报告六个不适配任务。(表 1,PDF 6;附录 D.1/D.4)
### 3.3 对照分别回答什么
| 方法 | 提示词 | 注意力 | 可解释的差异 |
|---|---|---|---|
| Vanilla | 原始材料内联、分步回答、统一 answer 标签 | 完整因果注意力 | 总体参考 |
| DA-no-mask($DA^{nm}$) | DA 的切段、工具对话、三模式提示词 | 完整因果注意力 | 相对 Vanilla 反映整个 DA 提示格式的影响 |
| DA | 同 DA-no-mask | 动态掩码 | 相对 DA-no-mask 反映启用掩码后的净影响 |
严格说,DA-no-mask 与 Vanilla 同时改变切段和模式指令,不是只改变“切段”一个变量;DA 与 DA-no-mask 的输出轨迹也会因掩码不同而变化。因此消融支持机制归因,但不是把同一固定轨迹简单重复计费。(本次分析)
没有与 Quest、DSA 等稀疏方法的直接性能对照,因此结果不能证明 DA 优于这些方案。
### 3.4 指标与评估可靠性
准确率是 LLM judge 判为正确的比例,格式失败算错;先在每个源内平均,再等权平均 15 个源,越高越好。attended tokens 是每回答累计位置数(M=百万),越低越好。Gemini-3-Flash 根据上下文和参考答案生成二元 rubric;启用 thinking 的 Qwen-3.5-4B 按 rubric 评判,评判器本身不重新读取原上下文。
附录 D.2 对 2,993 条回答用 Gemini-3.1-Pro 复判:逐条一致率 98.53%,95% CI [98.03,98.90],Cohen $\kappa=0.940$,按 cell 的 Pearson $r=0.992$,McNemar $p=0.65$。这说明两个评判器一致性高,不等于人类金标准已验证,也不排除共享 rubric 偏差。主任务性能差异没有相应置信区间或多随机种子检验,不能把小幅增益解释为显著提升。(图 7、表 9,PDF 33–34)
## 四:结果
### 4.1 主结果:以少量平均准确率损失换读取量
| 模型/方法 | 准确率 ↑ | Attended tokens(M/回答)↓ |
|---|---:|---:|
| Gemma Vanilla | 87.01% | 13.43 |
| Gemma DA-no-mask | 87.01% | 22.31 |
| Gemma DA | 85.74% | 6.45 |
| Qwen Vanilla | 85.31% | 22.54 |
| Qwen DA-no-mask | 84.62% | 29.02 |
| Qwen DA | 82.56% | 15.52 |
来源:表 2,PDF 8。Gemma 准确率下降 **1.27 个百分点**,成本减少 $(13.43-6.45)/13.43\approx52.0\%$;Qwen 对应 **2.75 个百分点**和 **31.1%**。小数值经过表格舍入。
分组上,Gemma 单跨度准确率 93.06%→92.28%,多跨度 74.92%→72.64%;Qwen 对应 93.07%→90.74%、69.78%→66.19%。多跨度准确率损失更大,符合需要跨段证据整合的困难,但不能仅凭分组均值确立原因。
Gemma 在 7/15 个任务匹配或超过 Vanilla,Qwen 为 5/15,很多匹配来自 NIAH 的准确率天花板。Qwen 有五个任务反而增加总 attended tokens,例如 qmsum 1.77M→2.67M、multidoc_qa 16.17M→20.89M、singledoc_qa 12.39M→18.00M。**平均省成本不意味着逐任务省成本。**
### 4.2 消融:收益来自掩码,协议本身增加步骤
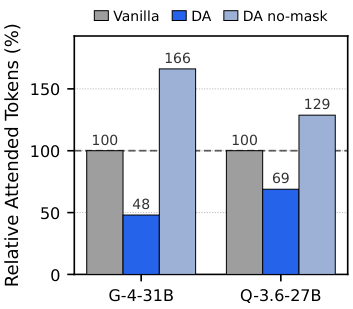
图 2(c),PDF 9。横轴是两个模型,纵轴是相对各自 Vanilla 的累计 attended tokens,Vanilla=100%;三组柱分别是 Vanilla、DA、DA-no-mask。DA 约为 48%/69%,无掩码时却为 166%/129%。
相对 DA-no-mask,DA 的总量减少 71.1%(Gemma)和 46.5%(Qwen)。无掩码的提示格式在 Gemma 上保持平均准确率,在 Qwen 上只下降 0.69pp,却明显增加成本。因此证据支持“动态掩码把协议额外开销变成净节省”,而不是“提示词让回答更短”。掩码同时带来多数准确率损失:相对 DA-no-mask,分别损失 1.27pp/2.06pp。(§5.1,PDF 7–9)
表 5(PDF 29)的平均解码步数更精确:Gemma 332→448,增加约 35%;Qwen 573→752,增加约 31%。论文有些概括语句称“15–35%”覆盖 DA 与 DA-no-mask 的不同柱,不宜混用为 DA 的专属范围。
### 4.3 模型规模:能力决定能否可靠遵循协议
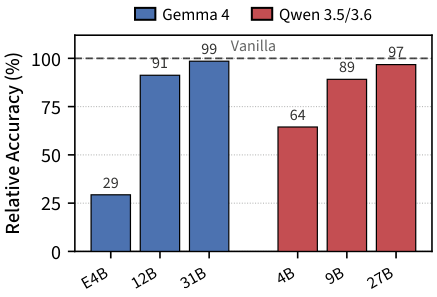
图 3(a),PDF 9。纵轴是 DA 准确率除以同模型 Vanilla 准确率,**不是绝对准确率**;横轴为模型规模。Gemma 从 E4B 的约 29% 提升到 31B 的约 99%,Qwen 从 4B 的约 64% 到 27B 的约 97%。
成本不随模型规模单调改善。Gemma-4-12B 的总 attended tokens 达 Vanilla 的 183%,约 6% 的 DA 回答未在 8K 内终止;排除双方未终止回答后降至 98%。这是失败尾部主导平均成本的例子。不能只报告过滤后的“也能省”,因为未终止是运行协议的真实风险。图注中“五个模型约一半”也需结合图内 Qwen 69% 和 12B 183% 理解为粗略概括。(§5.2,PDF 8–10;图 3)
### 4.4 上下文长度:绝对收益扩大,准确率仍有损失
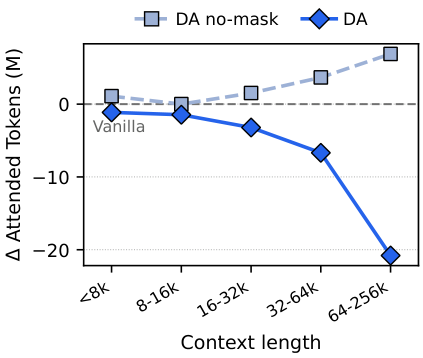
图 4(b),PDF 10。横轴为上下文长度分桶,纵轴为相对 Vanilla 的累计位置差(百万/回答);负数表示节省。Gemma 从短上下文约 −1M 增长到最长桶约 −21M。附录图 10(PDF 36)显示归一化总量约为 Vanilla 的 50–64%,因此“绝对节省变大”主要来自基数变大,而非比例无限提高。
图 4(a) 最长桶的相对准确率约为 96%;Qwen 在附录图 8(PDF 35)最长桶约为 92%,且成本逐渐向 Vanilla 接近。将 15 个任务混合分桶会改变任务构成,这不是固定同一任务、只改变长度的严格控制实验。21M 是分桶平均节省;表 2 某些单任务均值可更大,两者不矛盾。
### 4.5 效率估算:读得更少能否转化成时间收益
| 模型/方法 | 矩阵计算 ms | 全局读取 ms | 固定局部读取 ms | 总计 ms |
|---|---:|---:|---:|---:|
| Gemma Vanilla | 22.9 | 196.5 | 49.7 | 269.1 |
| Gemma DA | 30.9 | 94.4 | 67.1 | 192.3 |
| Qwen Vanilla | 34.4 | 263.8 | 8.0 | 306.2 |
| Qwen DA | 45.1 | 181.6 | 10.5 | 237.3 |
表 3,PDF 11;逐项推导见附录 C.8,PDF 28–29。条件为单 B200、bf16 峰值 2.25 PFLOPS、8 TB/s、MFU 40%、MBU 70%。表内项已舍入,总计可能有 0.1ms 的加总差。
Gemma 约为原来的 0.71×(约减少 28.5%),Qwen 约 0.77×(约减少 22.5%)。Gemma 全局读取降幅更大,却受 SWA 固定成本限制,不能直接得到 52% 时间下降。以上是饱和硬件上按工作量核算的每回答解码成本,不是用户请求实际只耗时约 0.2 秒的承诺。未包含 prefill、实际调度/解析和低并发开销;按 token 位置计数也未计入块向外对齐增加的读取(作者称全局项多几个百分点)。
附录 C.9–C.10(表 6–8,PDF 30–32)进一步用其他架构配置做成本外推,说明 1M 上下文时扫描仍可能重要;它们不是这些模型上实际运行 DA 的实验。128K 时部分已有稀疏架构的全局扫描占比已低于 50%,说明架构和长度会改变收益空间。此处仅解读本文列出的配置,没有独立验证外部模型配置。
### 4.6 模式效率与协议遵循
Gemma 约 27% 输出 token 在 global,focus/local 合计 73%;focus/local 的平均每步读取约是 Vanilla 的 12%/6%。图 5(PDF 12)按长度分桶展示模式占比和每 token 节省:越长时局部模式可省 76–99%,但最长桶 global 占比升到约 45%;Qwen 最长桶约 55%(图 9,PDF 36)。因此少量 global 步骤能贡献大多数读取;正文 §8.2 称 global 占 DA attended tokens 的 80% 以上。
图 6(PDF 12)显示合法 focus 引用成功率:Gemma 58%→99%,Qwen 89%→99%;平均每回答 focus 尝试约 1.4–1.9 次。该指标只说明标签解析为有效 chunk 引用,不代表选中了语义正确的证据段,也不代表整条回答协议完全正确。规模、格式遵循和准确率同时改善是支持性观察,尚未通过独立干预证明失败全部来自解析。
### 4.7 附录失败案例不能省略
| Gemma 上的任务源 | 准确率 Vanilla→DA | Attended tokens M,Vanilla→DA | 主要问题 |
|---|---:|---:|---|
| RULER cwe | 100.0%→70.3% | 26.50→25.12 | 全局计数/证据分解失败 |
| LBv2 structured_data | 68.4%→47.4% | 133.88→165.93 | 表结构被切开,质量和成本双降 |
| RULER fwe | 98.4%→99.2% | 3.22→6.16 | 枚举输出膨胀 |
| ZS summ_screen_fd | 23.4%→28.1% | 2.15→2.89 | 长输出抵消单步节省 |
| LBv2 in_context_learning | 69.1%→67.3% | 59.34→68.52 | 按实例处理,生成增长 |
| ZS book_sum_sort | 20.3%→13.3% | 6.64→7.22 | 排序任务也有明显质量下降 |
来源:表 10,PDF 35;附录 D.4,PDF 33–35。六源平均准确率 63.28%→54.26%,成本 38.62M→45.97M。它们不在主文 15 源平均里。作者把前两者归为分段/任务分解破坏可用证据,后四者归为输出长度增长,但后四者不是每个任务都“准确率无损”,book_sum_sort 就下降约 7pp。
这里“证据被分段破坏”不能理解为字符被删掉:附录 F 的分段是无损的;问题是局部可见性和推理方式不适合跨段关系、表结构或全局统计。部分 RULER 任务提示又要求只输出答案,与 DA 的推理协议冲突。结构感知切段、map-reduce、SFT/RLVR 都是作者提出的解决方向,本文未验证能解决这些失败。
## 五:结论
### 5.1 已经建立了什么
本文提供了“文本声明可以控制实际注意力读取”的零样本可行性证据。强模型在若干检索和局部证据整合任务中,能够通过导航—抽取—汇总的过程大幅减少累计全局 KV 位置读取。DA-no-mask 消融支持节省主要来自真实掩码;模型越强,协议遵循和相对准确率通常越好。
### 5.2 尚不能推出什么
不能推出无损加速、显存容量减少、所有长任务获益、实测端到端低延迟,也不能推出全面胜过已有稀疏注意力。更不能把“零样本结果是下界”当作训练后必然改进的定理:它是研究潜力判断。性能结论依赖挑选的任务、模型能力、原生 thinking 关闭、额外生成量和评估 rubric。
原文有一处小的报告不一致:附录 D.1(PDF 32)说表 1 列出了各源池大小 $N$,但实际表 1(PDF 6)没有 $N$ 列。因此不能从这段话补出各任务确切评估样本数;本笔记只采用明确报告的“每源至多 128”。
### 5.3 后续最有价值的验证
1. 在指定 batch、上下文分布和并发条件下测真实 TTFT、每输出 token 延迟、吞吐,计入预填充、解析、块表更新及额外生成。
2. 把六个失败源并入统一报告,并给任务内准确率/成本分布、置信区间和长尾未终止率。
3. 与既有稀疏方案用相同模型、任务、成本预算对照,验证 global 阶段是否值得组合轻量扫描。
4. 验证训练或原生工具接口能否在 thinking 模式中稳定遵循协议;测试真实多轮 agent 工具上下文,而非只测试预构造的静态工具对话。
这些是本次分析的后续建议。论文讨论的推测解码协作、KV offloading、可逆上下文压缩和 RL 优化都尚属未来工作。最值得带走的观点是:**推理输出除了表达答案,还可以成为运行时的可读控制接口;收益必须连同控制开销、失败率和系统瓶颈一起核算。**